Lesson 09 · คาบบ่าย 28 ต.ค. (วิดีโอ 1:34–1:52) · ~25 นาที
RAG และ Fine-tuning เทียบกับ RAG
1ปัญหา: Hallucination
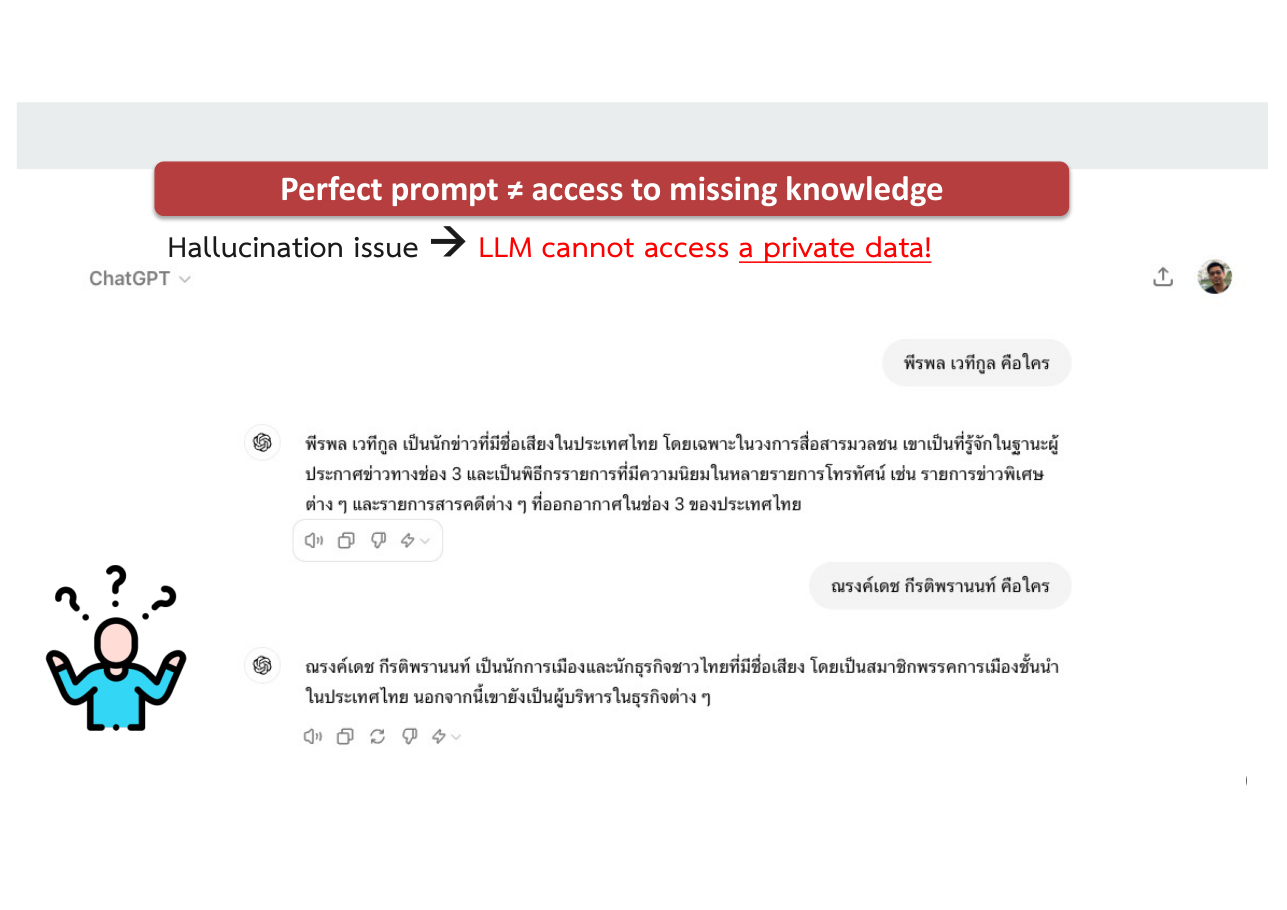
ถามโมเดลว่าชื่ออาจารย์คนหนึ่ง (เช่น "พีรพล") คือใคร โมเดลตอบจากความจำ (memory) จึงตอบมั่วได้ เพราะเป็นข้อมูลที่ไม่มีในการ pretrain
วิธีแก้: ไปค้นจาก ฐานข้อมูลที่น่าเชื่อถือ ก่อน เช่นฐานข้อมูลภายในบริษัท แล้วค่อยตอบจากเอกสารนั้น
2RAG: Retrieval-Augmented Generation
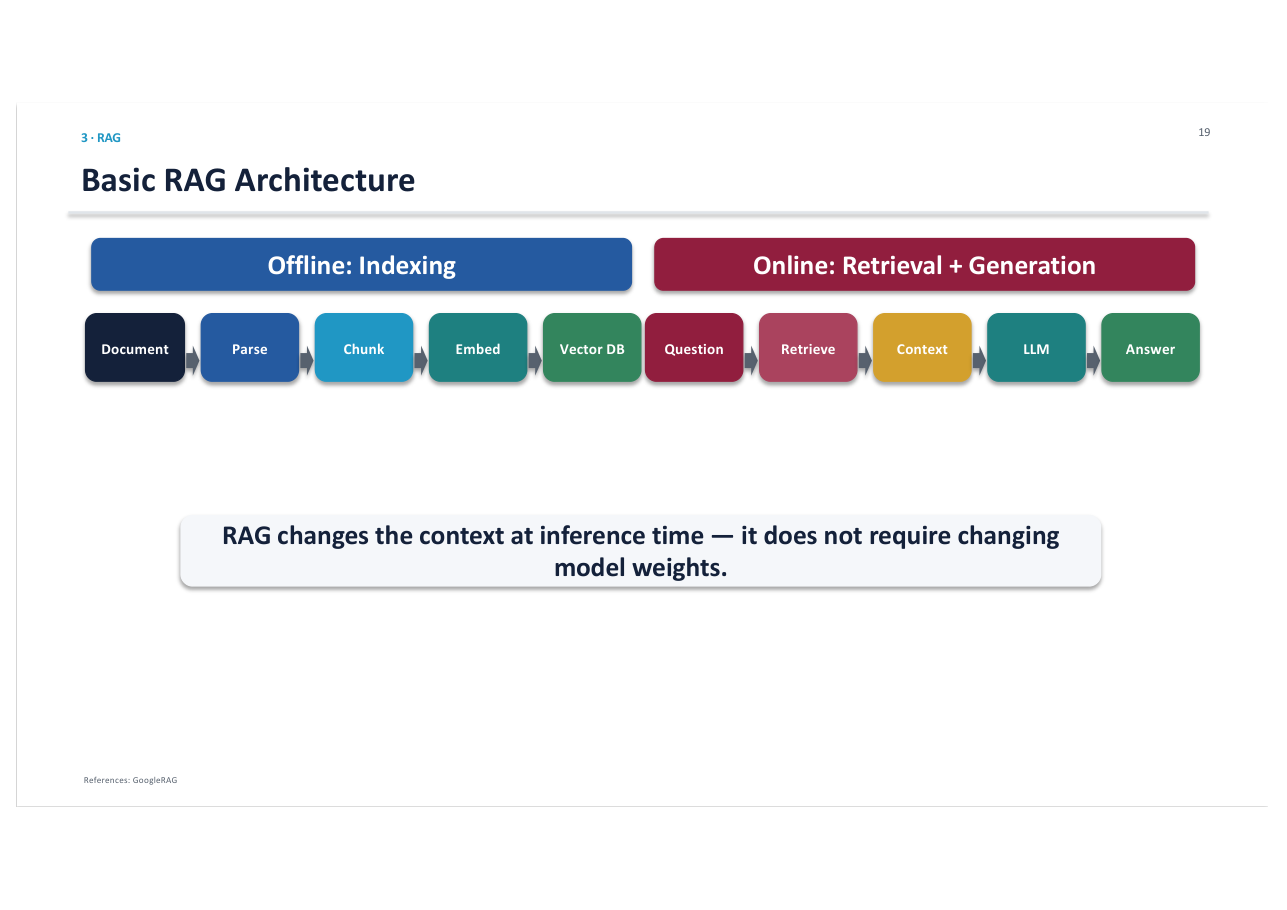
ค้นเอกสาร (Retrieval) → นำเอกสารที่ค้นมาเสริมเป็น context (Augment) → ให้ LLM เขียนคำตอบ (Generation) ไม่แก้ weight ของโมเดล
เอาเอกสารที่สืบค้นได้มา augment แล้ว generate เป็นคำตอบ: "จงตอบคำถามข้อนี้โดยอ้างอิงจากเอกสารนี้" แทนที่จะตอบจากความมั่ว ๆ
ขั้นที่ 1: Parse และ Chunk
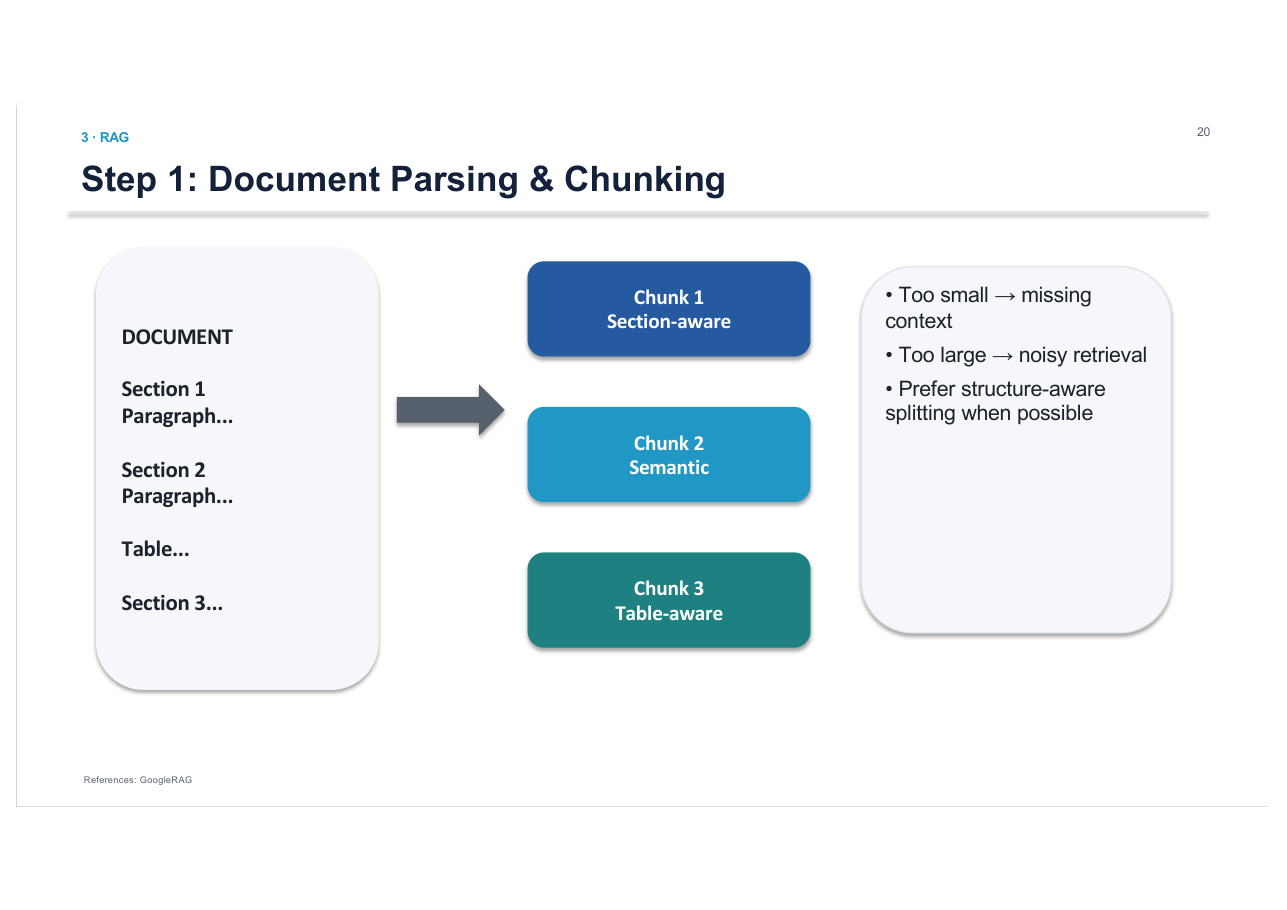
ขั้นแรกคือเตรียมเอกสารและ chunking ตัดเอกสารให้เป็นท่อนเล็ก ๆ
- chunk เล็กเกิน → ขาด context
- chunk ใหญ่เกิน → ดึงมาแล้วมี noise
- ถ้าทำได้ ตัดตามโครงสร้าง (หัวข้อ ตาราง)
ขั้นที่ 2: Embedding
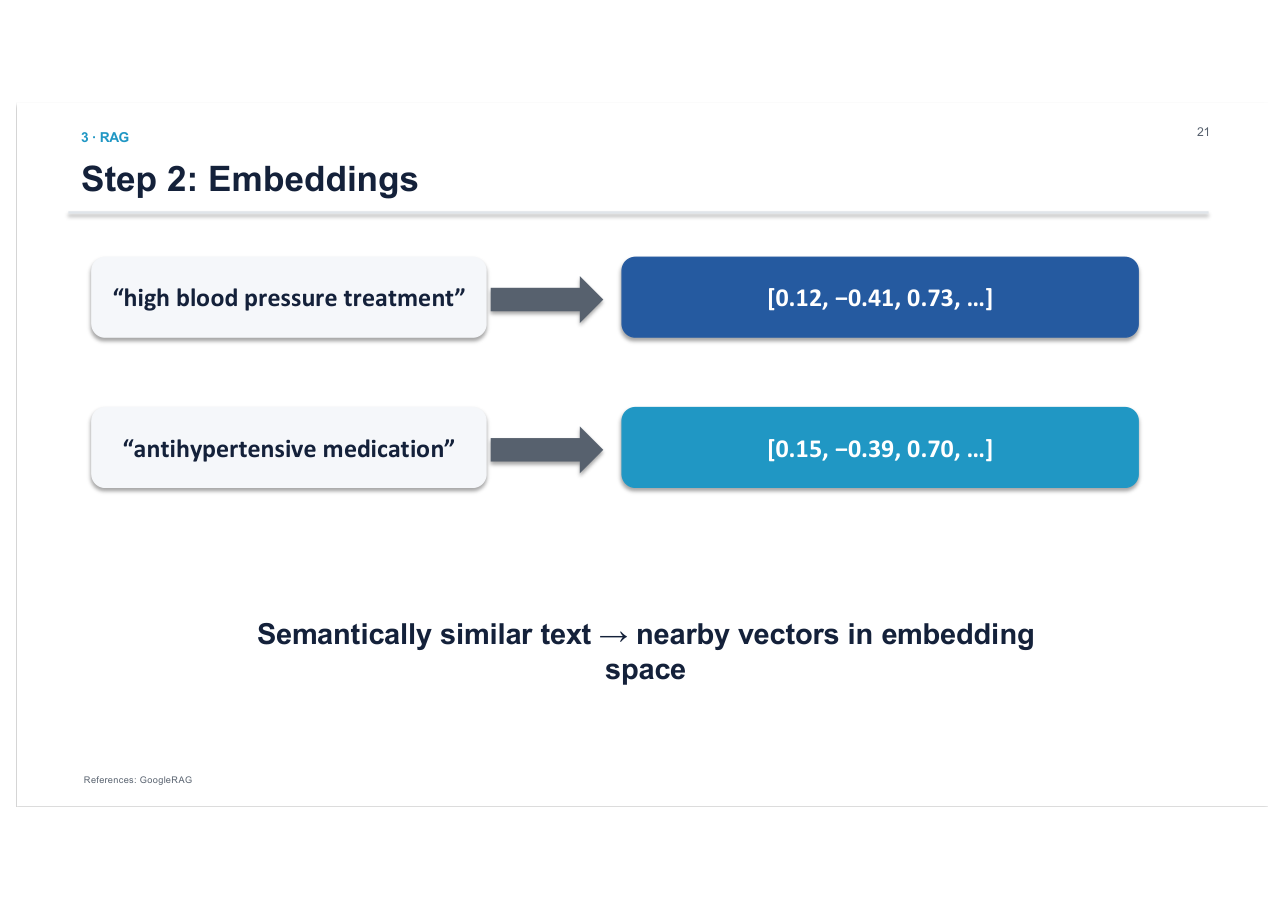
แปลงแต่ละ chunk เป็น embedding vector (ต่อจากบท 4: ข้อความก็เป็น non-tabular ที่ DL แปลงเป็นเวกเตอร์ได้) เก็บใน Vector DB ข้อความที่ความหมายใกล้กันจะได้เวกเตอร์ใกล้กัน
เอาเวกเตอร์ของคำถามไปสืบค้นในฐานข้อมูลเวกเตอร์ เทคนิคสืบค้นมีหลากหลาย อาจารย์ไม่ลงรายละเอียด
ขั้นที่ 3: Vector search
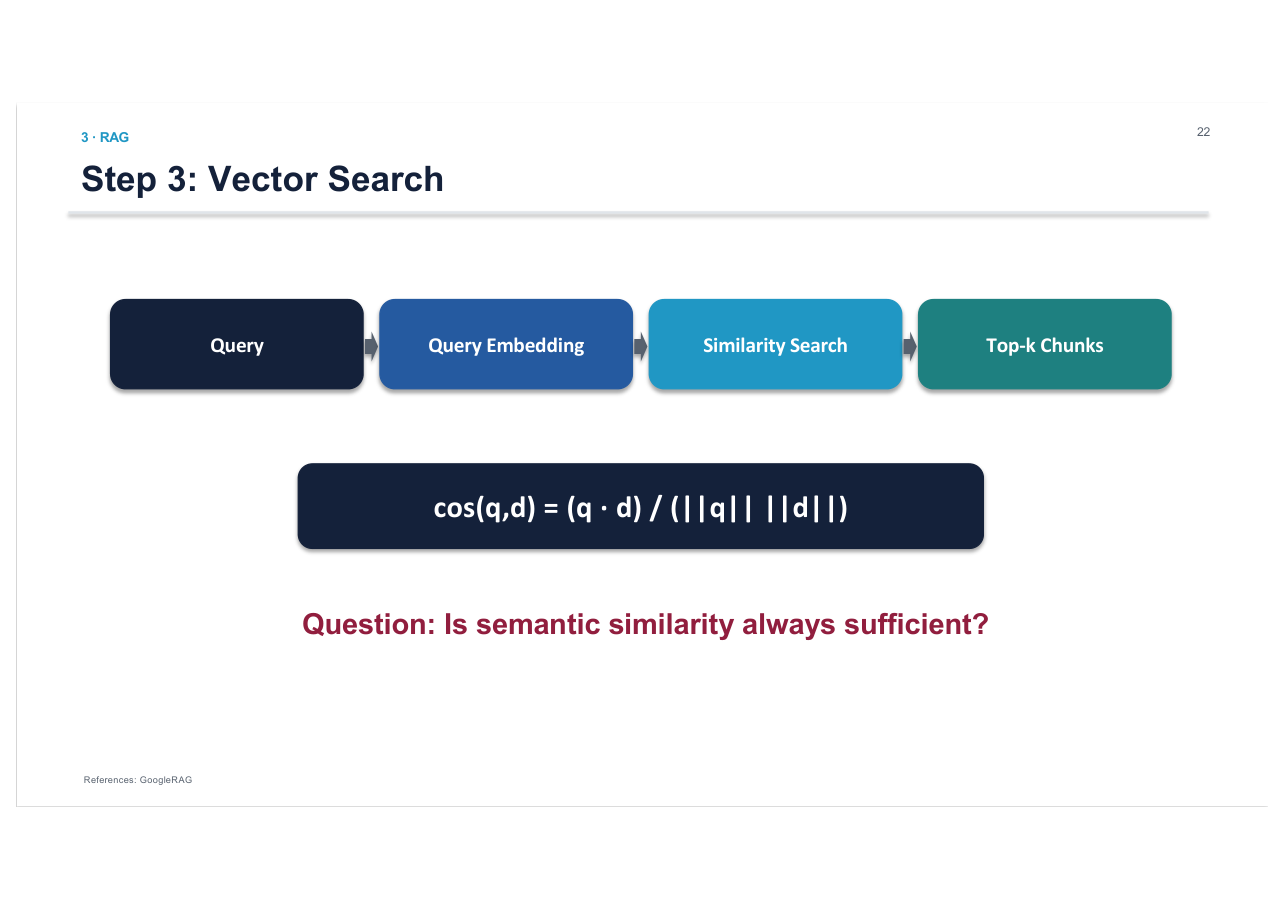
$$ \cos(q,d)=\frac{q\cdot d}{\lVert q\rVert\,\lVert d\rVert} $$
ลากเวกเตอร์ของคำถามไปรอบ ๆ ดู chunk ที่มุมใกล้กัน (cosine สูง) ถูกเลือกเป็น top-k
ยิ่งใกล้ 1 ยิ่งความหมายใกล้ ดึง top-k chunk มาเป็น context
ขั้นที่ 3.5: Sparse, Dense, Hybrid, Rerank
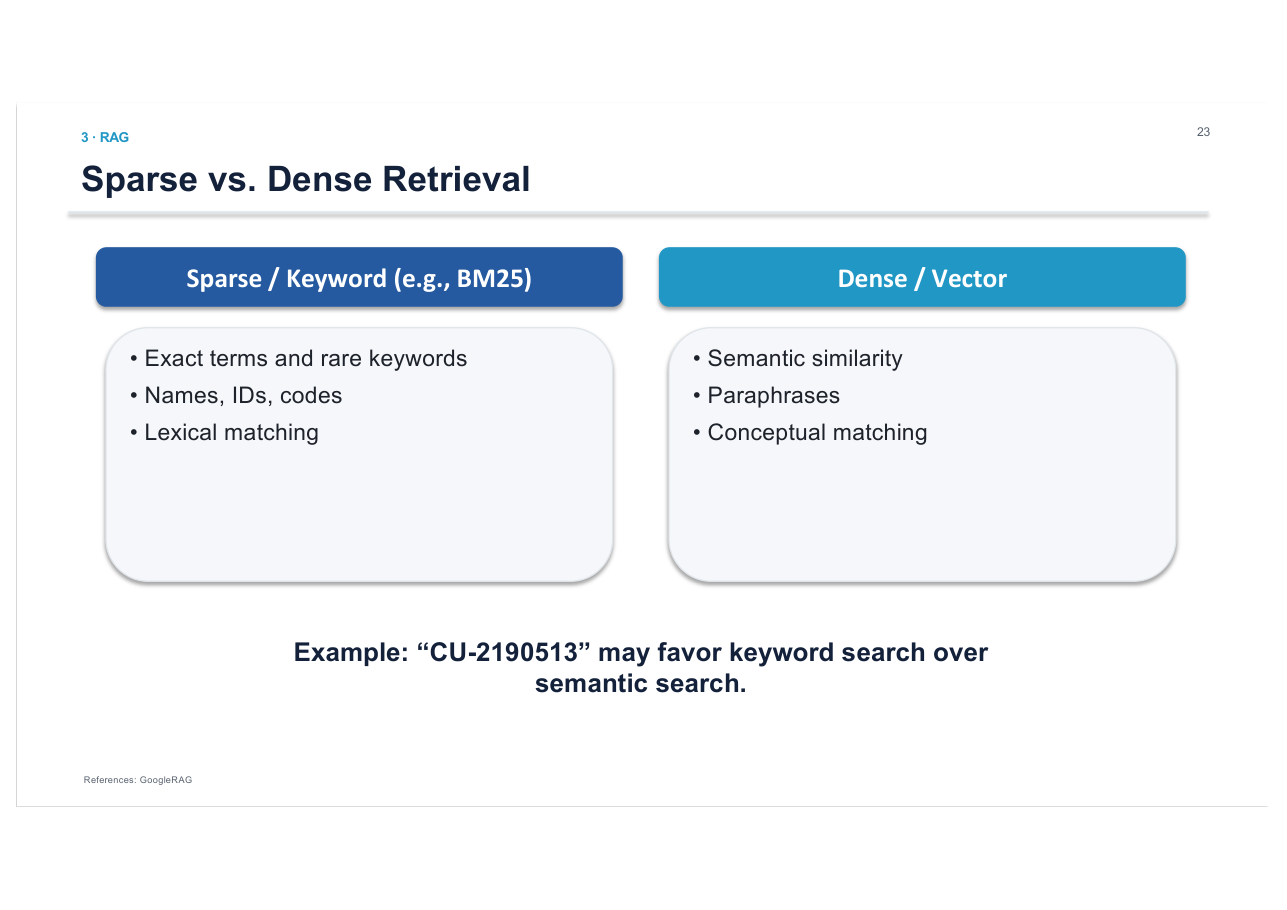
| Sparse / Keyword (BM25) | Dense / Vector | |
|---|---|---|
| ถนัด | คำเฉพาะ ชื่อ รหัส | ความหมาย ความหมายแฝง |
| จุดอ่อน | ไม่เข้าใจคำพ้อง | พลาดคำเฉพาะ/รหัส |
Hybrid = ใช้ทั้งสองอย่าง (สไลด์ 47: ไม่ได้แทนกัน แต่เสริมกัน)
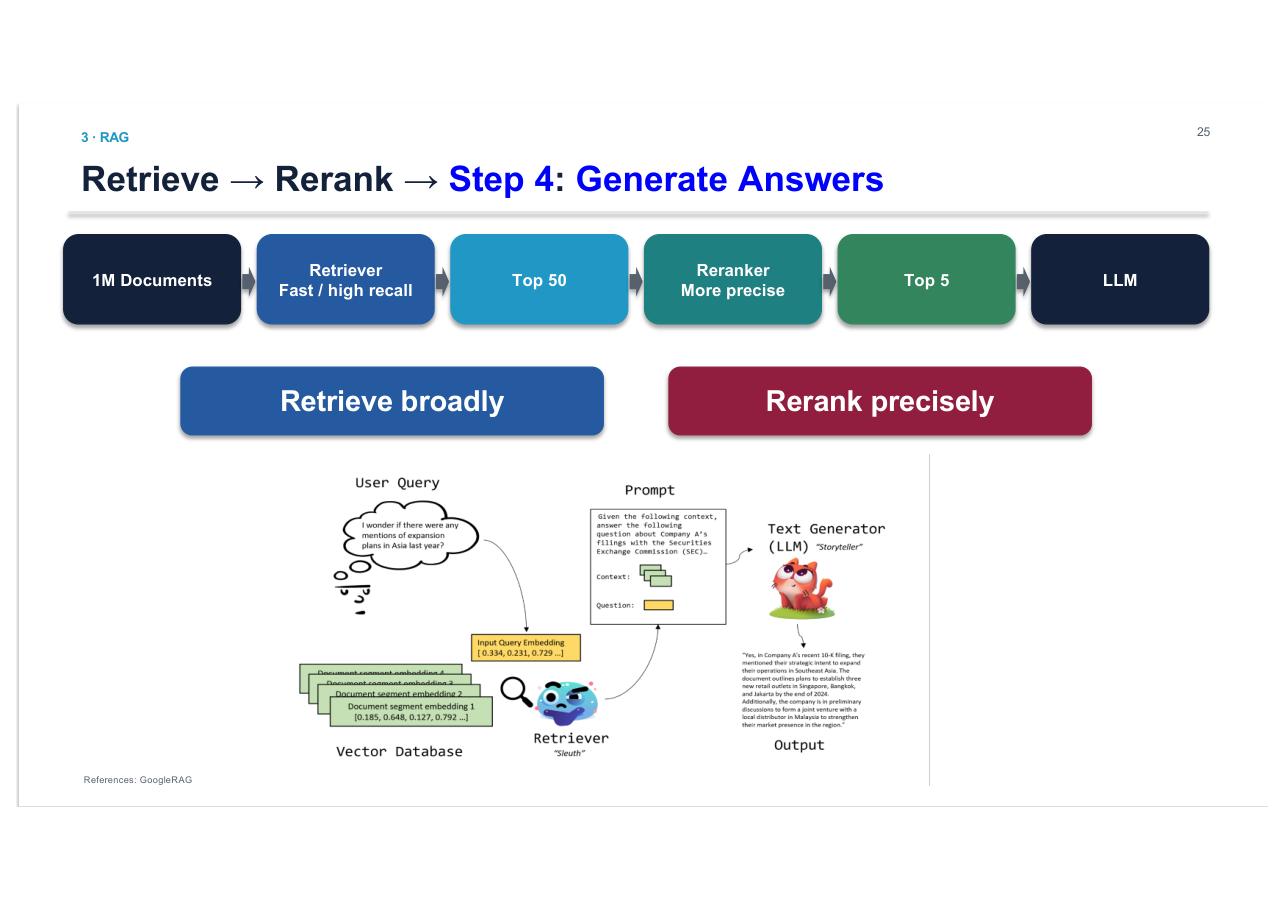
Retrieve กว้าง ๆ ก่อน (recall) แล้ว Rerank ให้แม่น (precision) ส่งเฉพาะ top 5 ให้ LLM
ขั้นที่ 4: Generate
LLM อ่าน question + context ที่ค้นได้ แล้วตอบ ถ้า retrieval แย่ hallucination ยังเกิดได้ (สไลด์ 51: "Higher if retrieval techniques/tools is weak")
3Fine-tuning เทียบกับ RAG
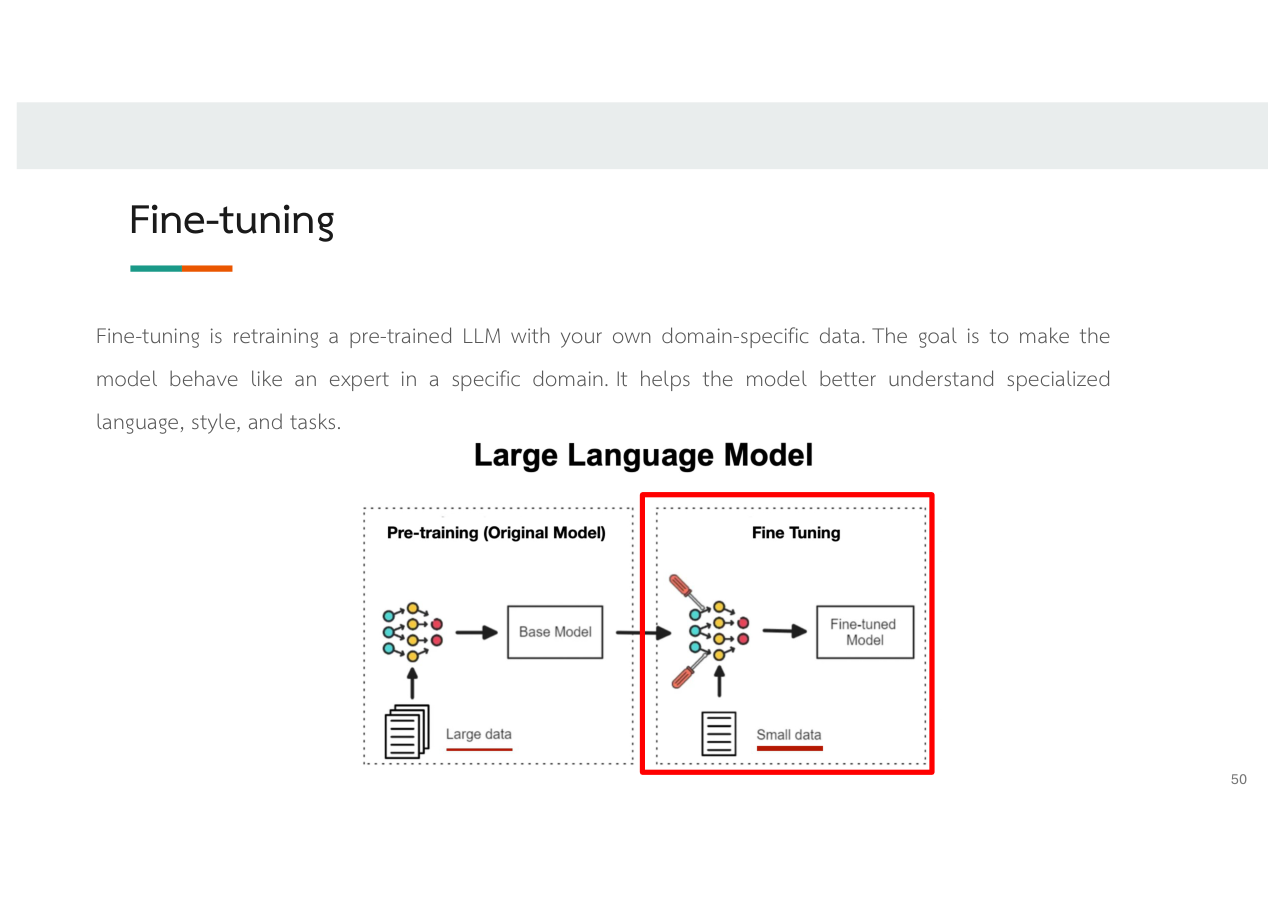
Fine-tune LLM คือการเทรนต่อยอดบน pretrained LLM ที่มีอยู่ ถามว่าแพงไหม? แพง เพราะ LLM ใหญ่มาก
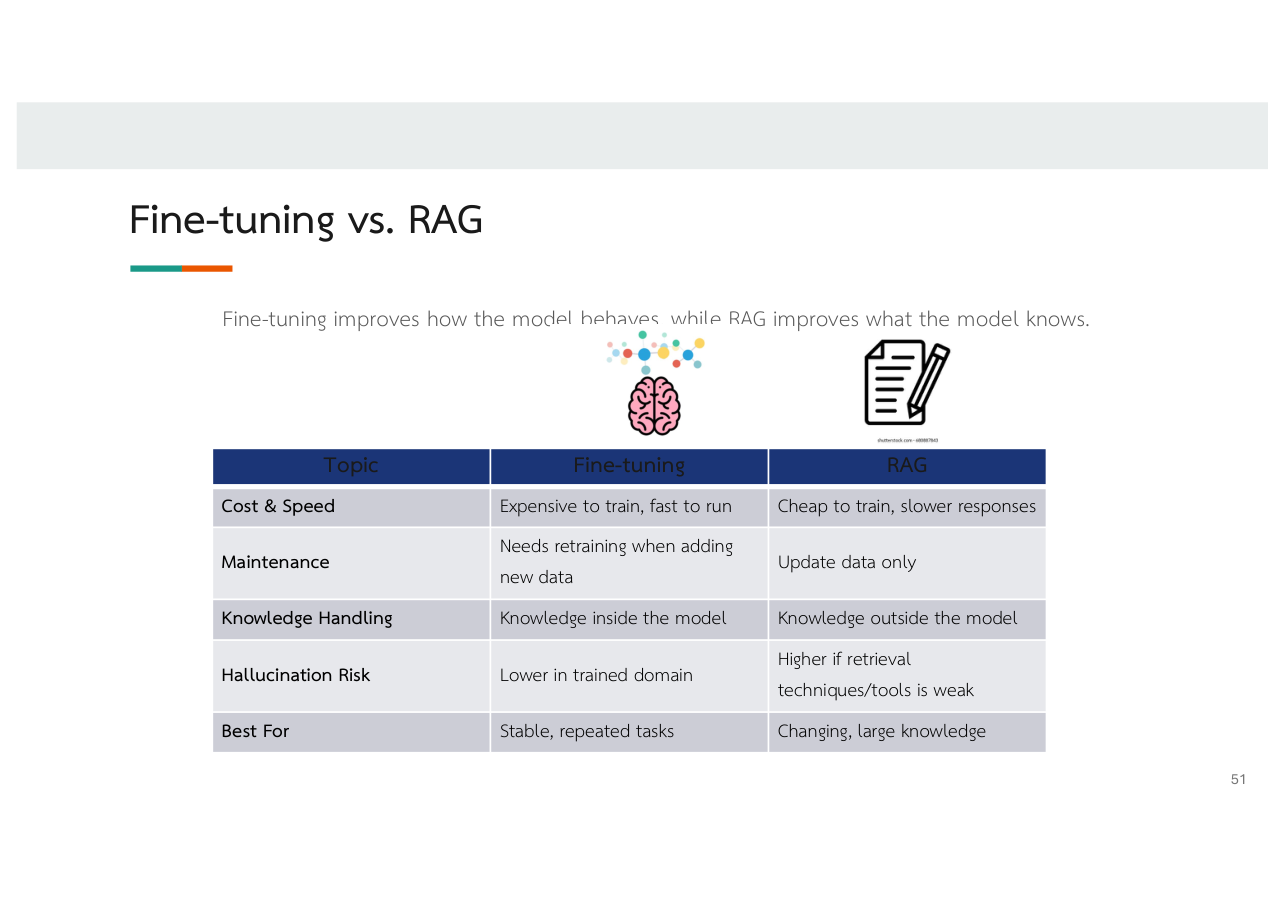
| หัวข้อ | Fine-tuning | RAG |
|---|---|---|
| ต้นทุน/ความเร็ว | เทรนแพง ใช้งานเร็ว | เทรนถูก ตอบช้ากว่า |
| ดูแล | ต้อง retrain เมื่อข้อมูลใหม่ | อัปเดตข้อมูลอย่างเดียว |
| ความรู้ | อยู่ ใน โมเดล | อยู่ นอก โมเดล |
| Hallucination | ต่ำในโดเมนที่เทรน | สูงถ้า retrieval อ่อน |
| เหมาะกับ | งานคงที่ซ้ำ ๆ | ความรู้เปลี่ยน/ใหญ่ |
Fine-tuning ปรับ พฤติกรรม (how the model behaves) · RAG ปรับ ความรู้ (what the model knows)
ปกติเรานิยมไป prompt/RAG ก่อน ถ้ายังอยากเปลี่ยนพฤติกรรมของโมเดลจึงค่อยไป fine-tune
ถ้าต้องการให้ LLM ตอบคำถามเรื่องกฎหมายได้ → RAG (เพิ่มความรู้) แต่ถ้าต้องการให้ "พูดเหมือนหมอ/นักกฎหมาย" (เปลี่ยนพฤติกรรมการพูด) → fine-tune
ไม่จำเป็นต้องเลือกระหว่าง fine-tune กับ RAG ใช้ทั้งคู่ร่วมกันได้
อย่าตอบว่า "ใช้ fine-tune เพื่อให้โมเดลรู้ข้อมูลล่าสุด" ข้อมูลที่เปลี่ยนบ่อยเหมาะกับ RAG ส่วน fine-tune ต้องเทรนใหม่ทุกครั้งและแพง
4ธีมของอาจารย์: เลือก pretrained model ให้ถูกโดเมน
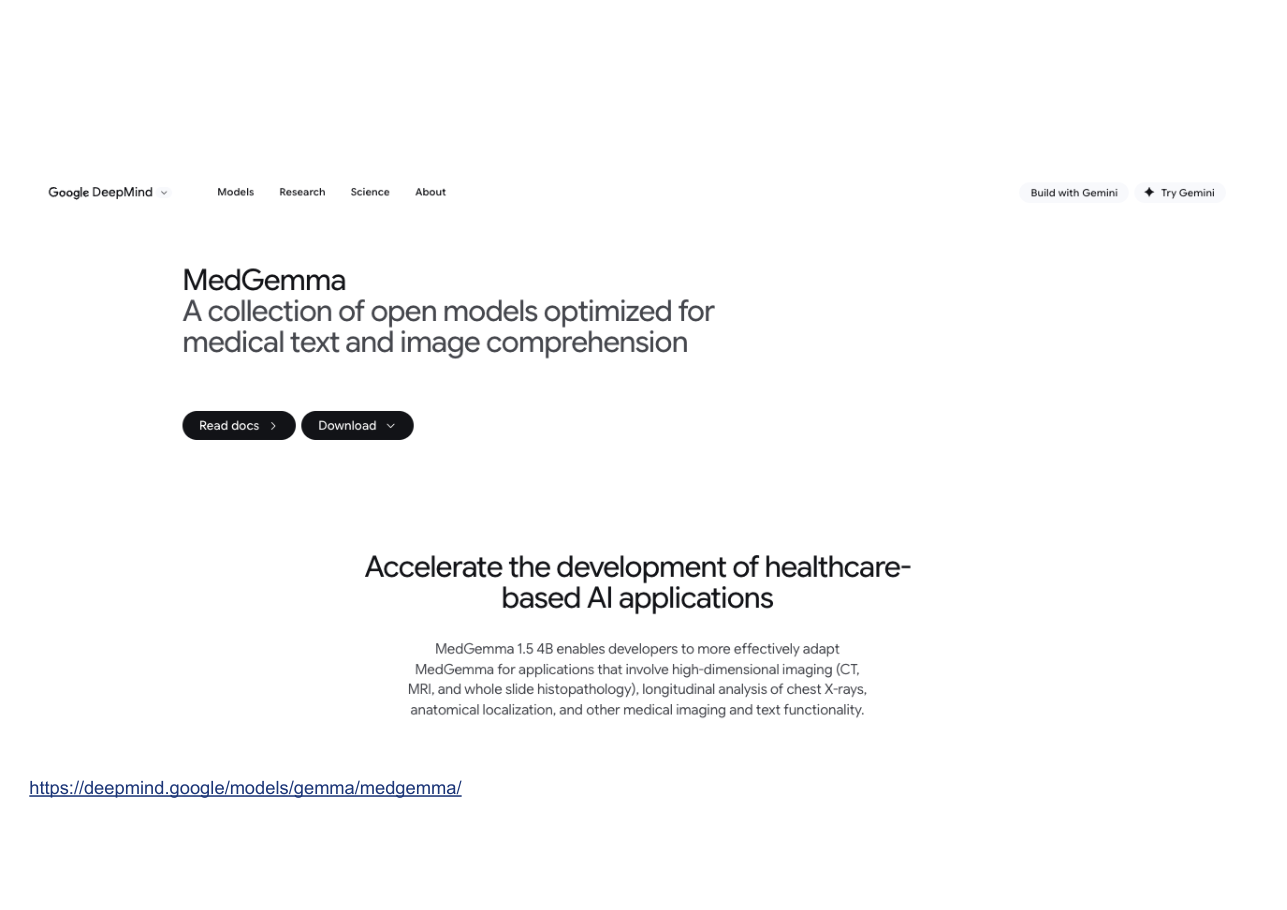
ตอนนี้ต้องดูด้วยว่าโมเดลถูก pretrain บนข้อมูลอะไร ไม่ใช่ดูแค่ขนาด เช่น MedGemma ปรับ Gemma ด้วยข้อมูลการแพทย์ให้เป็นผู้เชี่ยวชาญฝั่งแพทย์ และ WeatherNext pretrain บนข้อมูลอากาศ
5ลองทำ
- Google Cloud: What is RAG แหล่งที่สไลด์อ้าง (GoogleRAG)
- Pinecone: Learn RAG อธิบาย chunking และ reranking เพิ่ม
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย