Lesson 08 · คาบบ่าย 28 ต.ค. (วิดีโอ 1:09–1:34) · ~30 นาที
LLM และ Prompt Engineering
1Predictive AI กับ Generative AI
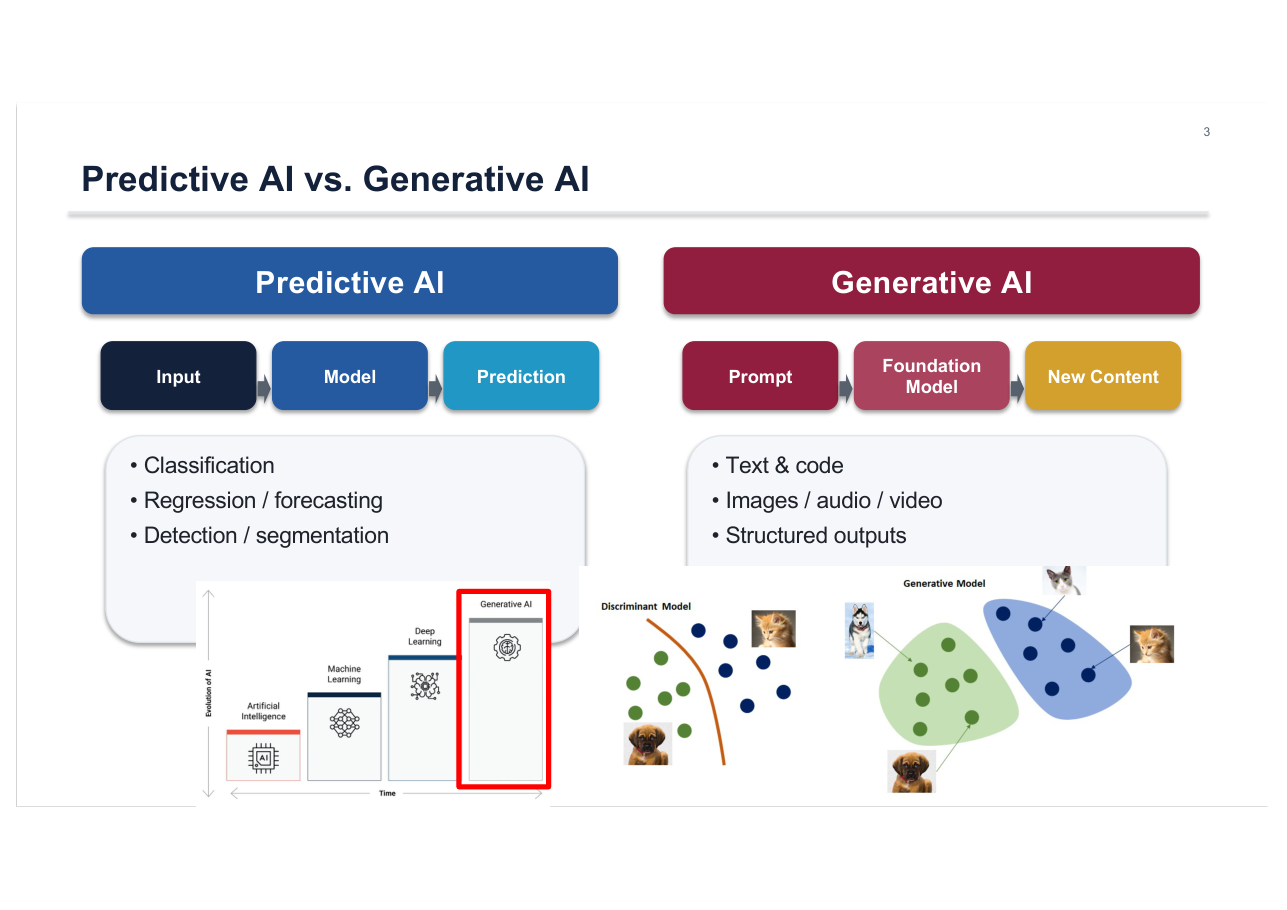
โมเดลที่แบ่งหมา-แมวเป็น discriminative (หาเส้นแบ่ง) ข้อมูลมากขึ้นก็สอนให้รู้จักหมาทั้งโลกได้ ส่วน generative เล็กหรือใหญ่กว่า? ใหญ่กว่ามาก เพราะต้องกักเก็บความรู้ไว้ในตัวเพื่อสร้างของใหม่
ความสามารถ generative จะไม่เกิดเลยถ้าโมเดลไม่ใหญ่พอที่จะกักเก็บความรู้
2Language model: ทำนายคำถัดไป
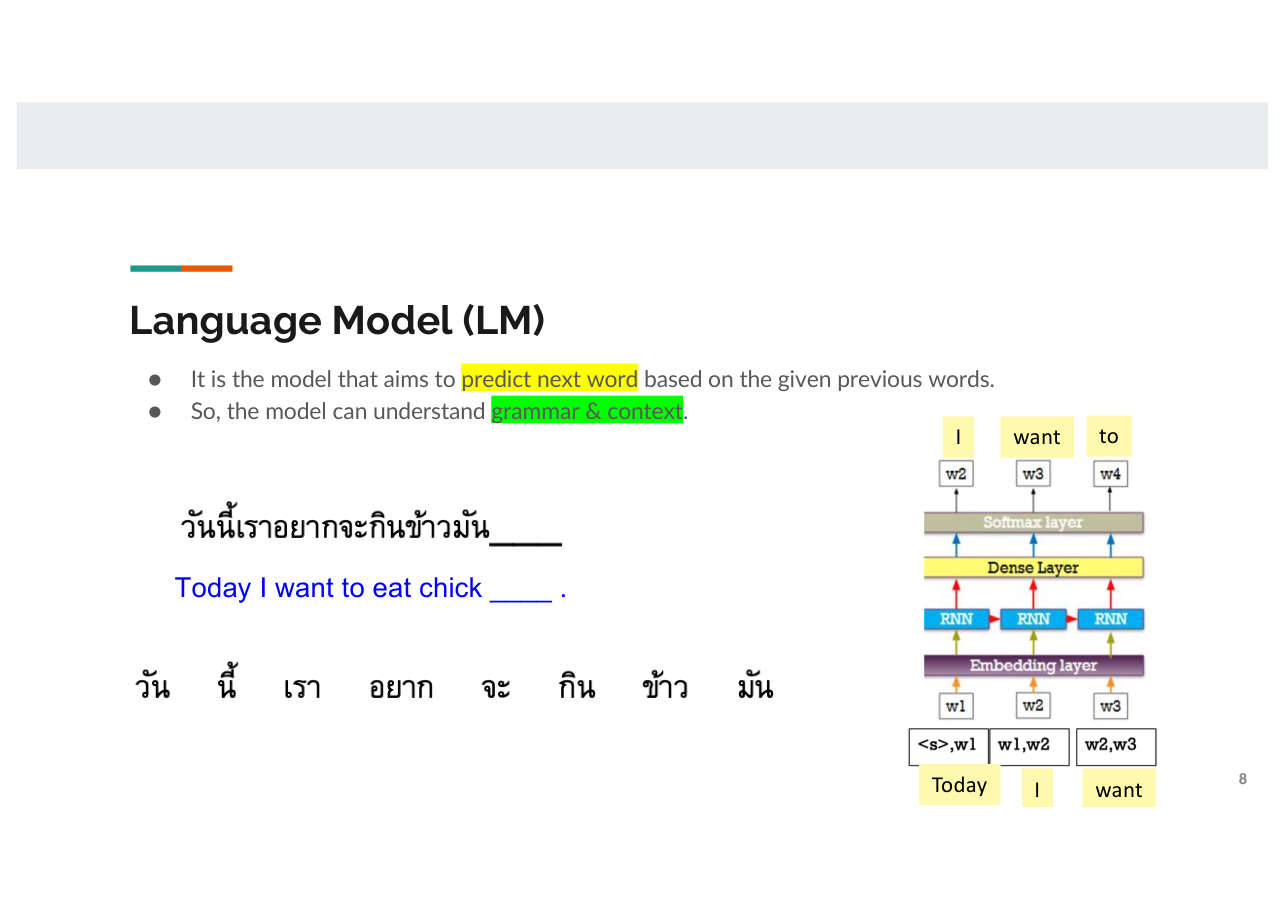
LM คือโมเดลทำนาย "คำถัดไป" แค่นั้นเองหรือ? ใช่ ถ้าทำนายถูกก็แปลว่าเข้าใจ context (ข้าวมันต้องไก่) เหมือน auto-complete ที่เราใช้อยู่
เมื่อ LM เทรนจากข้อความ ไม่ต้องมีคนมาทำ label หรือ target เลย เพราะคำถัดไปในข้อความคือเฉลยอยู่แล้ว เป็นการเรียนรู้บนข้อมูลมหาศาลโดยไม่ต้องมี label
ลองเลื่อน temperature แล้วกดสุ่ม ดูว่าคำถัดไปเปลี่ยนได้อย่างไร (temperature ต่ำ = เลือกคำที่น่าจะเป็นที่สุด สูง = กระจายมากขึ้น)
เรียกโมเดลตั้งต้นนี้ว่า language model / pretrained model (ตรงกับบท 6: โมเดลที่เทรนมาก่อน) และพอ ใหญ่มาก จึงเรียก Large LM = LLM
3จาก LM เป็น ChatGPT
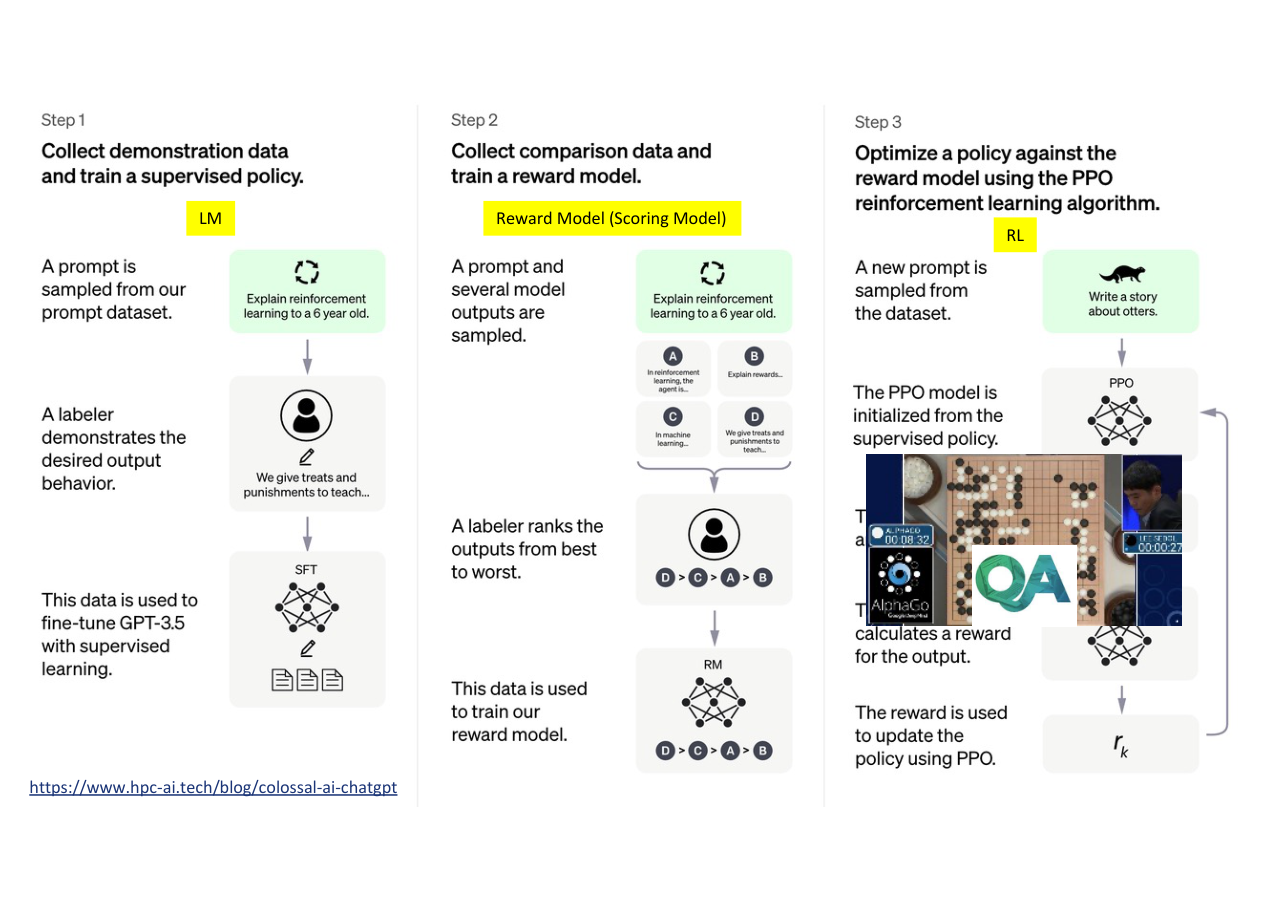
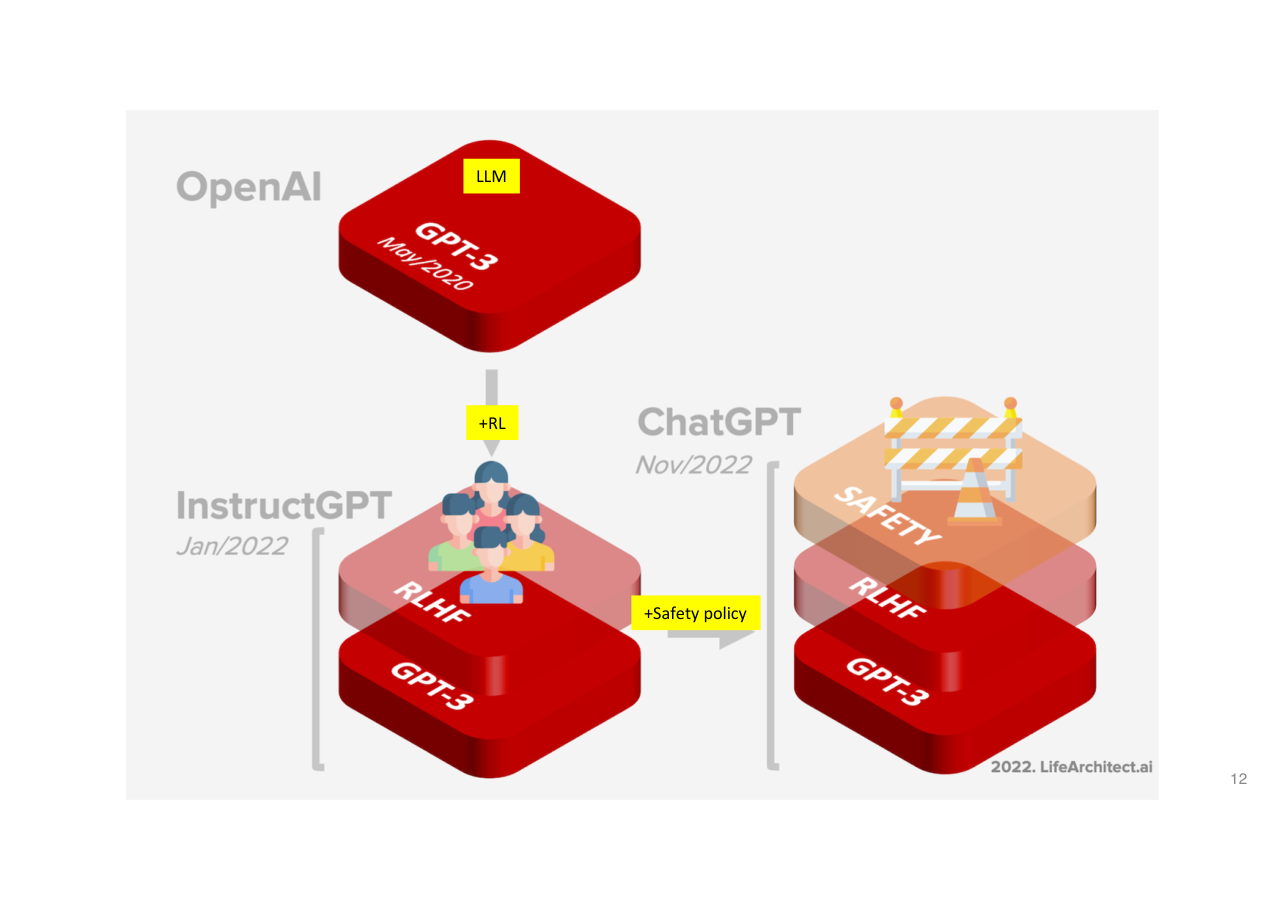
โมเดลตั้งต้นที่ทำนายคำถัดไป ถูกนำไปทำ RL (เหมือนเล่นเกม) ให้ตอบตามที่คนชอบ แล้วติด safety policy จึงกลายเป็น ChatGPT
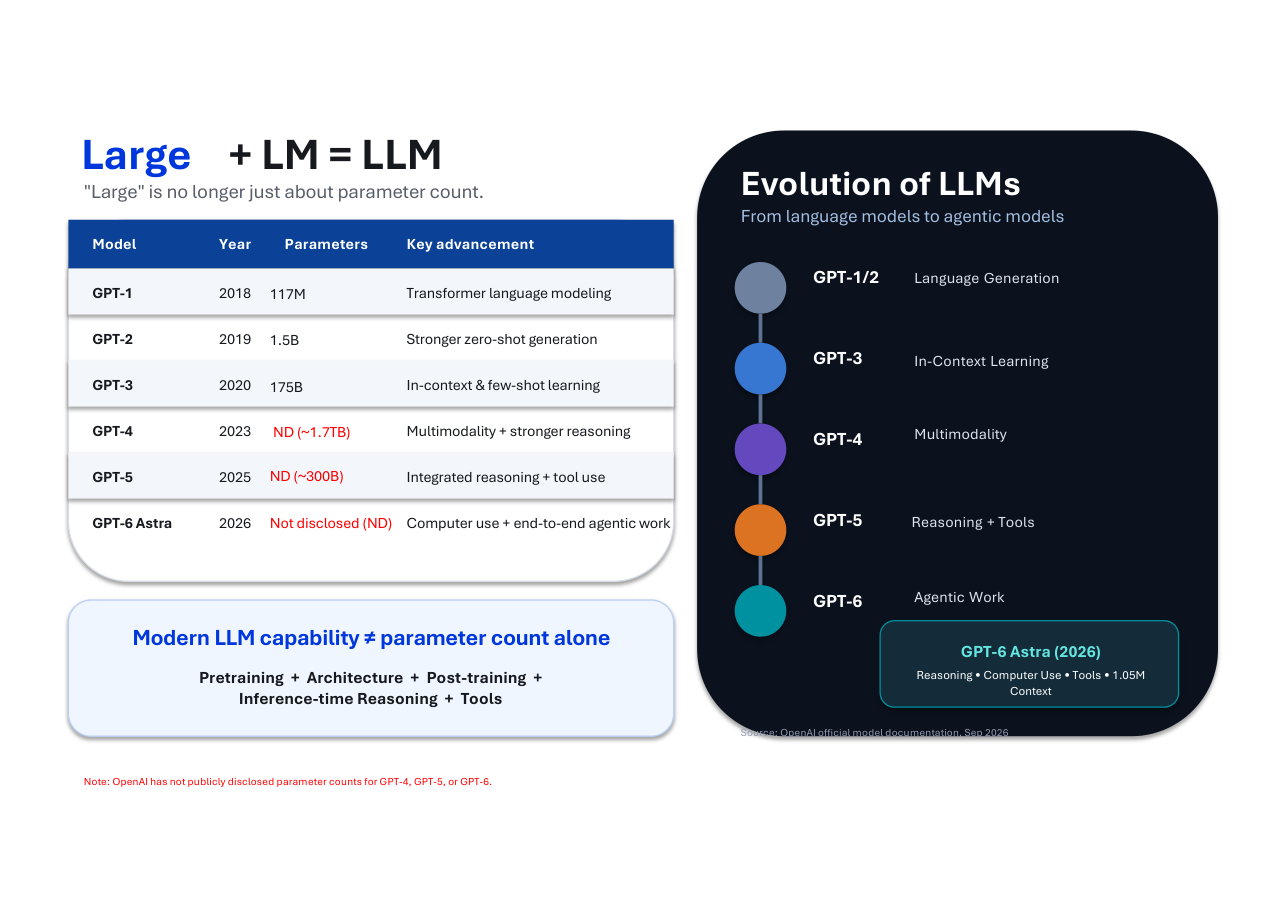
- GPT-3 (2020) 175B พารามิเตอร์ (1:20:32)
- ยุคแรกแข่งกันที่ความสามารถโดยไม่สนต้นทุน ยุคที่สองเข้าสู่ reasoning model (1:22:40)
- สไลด์ 13: Modern LLM capability ≠ parameter count alone = pretraining + architecture + post-training + inference-time reasoning + tools
ชื่อรุ่นและราคาในสไลด์ 15–27 (GPT, Claude, Gemini, Qwen, DeepSeek) เป็นข้อมูล ณ 25 ก.ย. 2026 อาจารย์ย้ำให้เลือกโมเดลตามงาน/ราคา/ความเร็ว (artificialanalysis.ai) ไม่ใช่จำชื่อ
4Prompt engineering
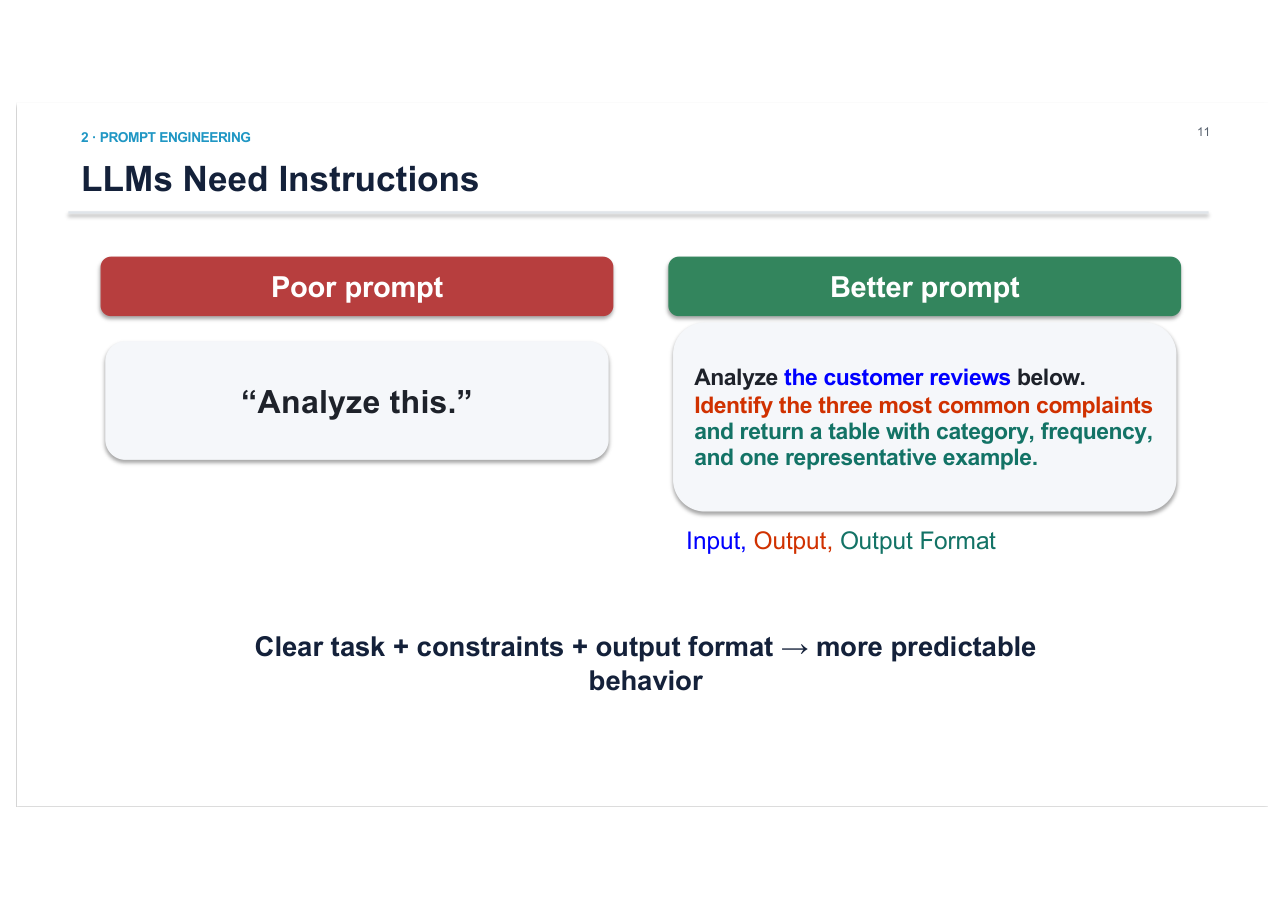
เราต้องเขียนคำสั่ง (prompt) ให้ถูกต้อง LLM ต้องการ instruction เช่น "ต้องการ top 3 most common complaints"
System prompt และ User prompt
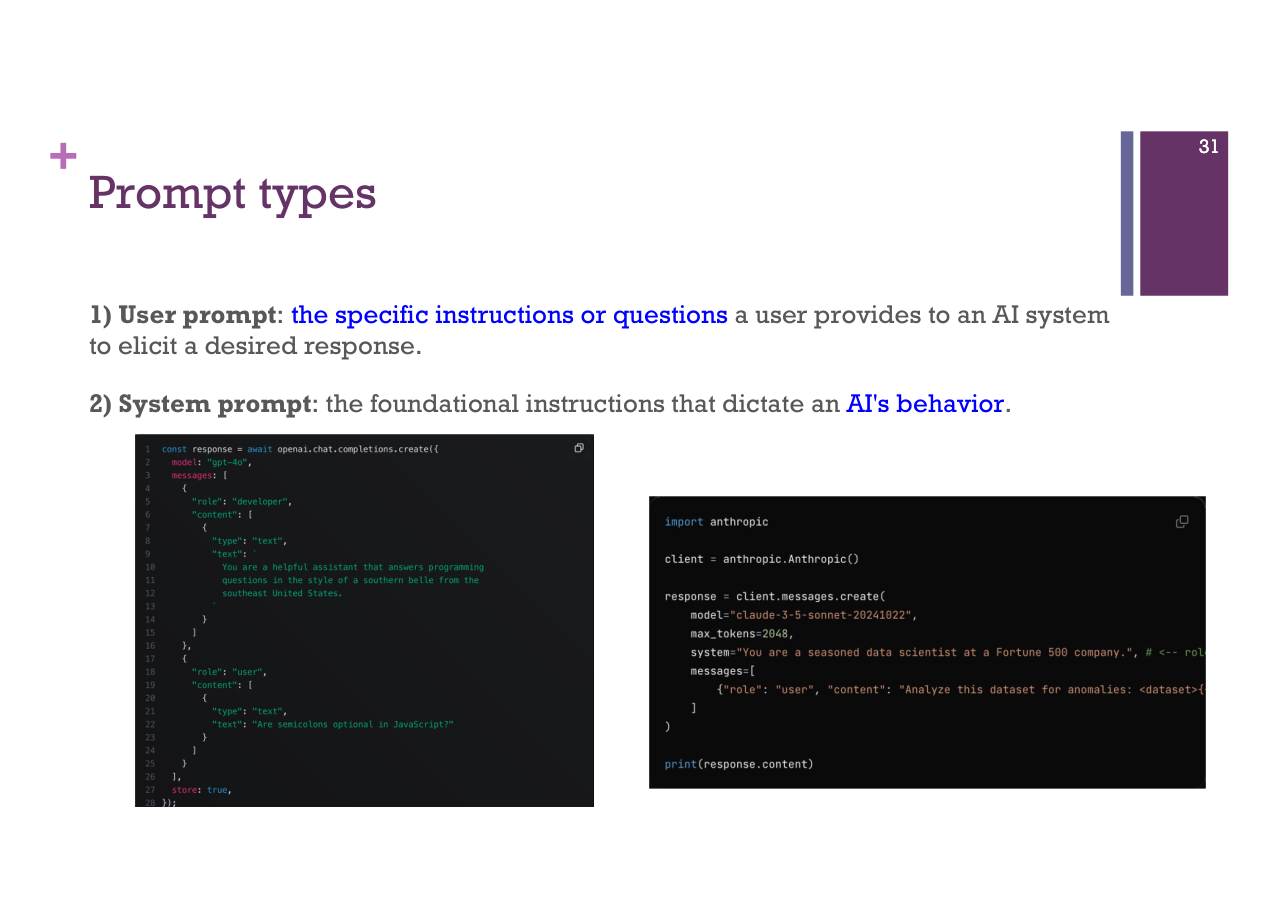
ต้องรู้จักคำว่า user prompt กับ system prompt: system กำหนดบทบาท/พฤติกรรมพื้นฐาน เช่น "คุณคืออาจารย์ที่เชี่ยวชาญ..." user prompt คือคำสั่งเฉพาะงาน เช่น "จงเขียนรายงานเกี่ยวกับ AI"
ICIO: องค์ประกอบของ prompt
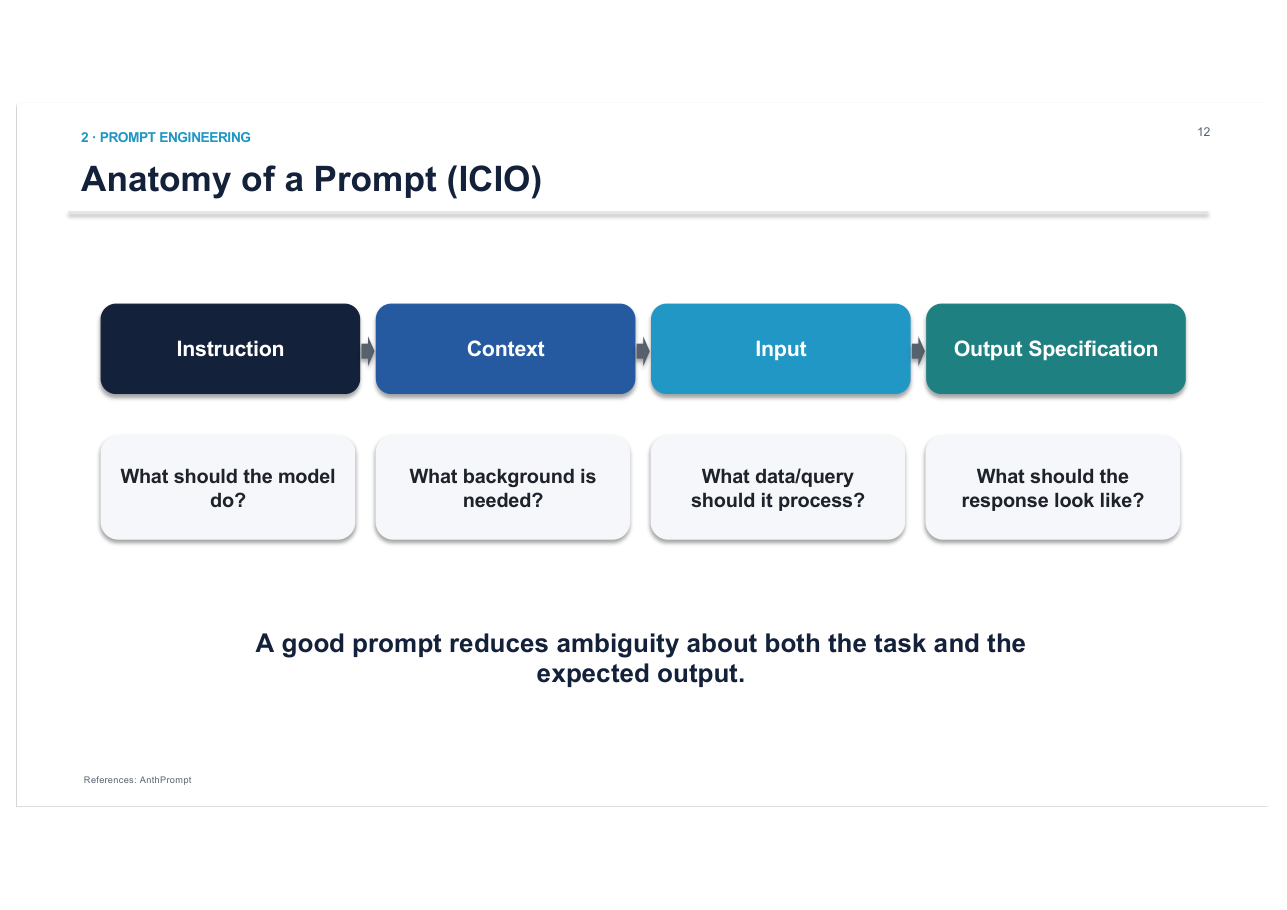
Instruction (ให้โมเดลทำอะไร) · Context (ต้องมีพื้นหลังอะไร) · Input data (ข้อมูล/คำถามที่ต้องประมวลผล) · Output indicator/specification (รูปแบบผลลัพธ์)
คำสั่งชัด บริบทชัด อินพุตครบ และกำหนดฟอร์แมตเอาต์พุต
Zero-shot vs Few-shot
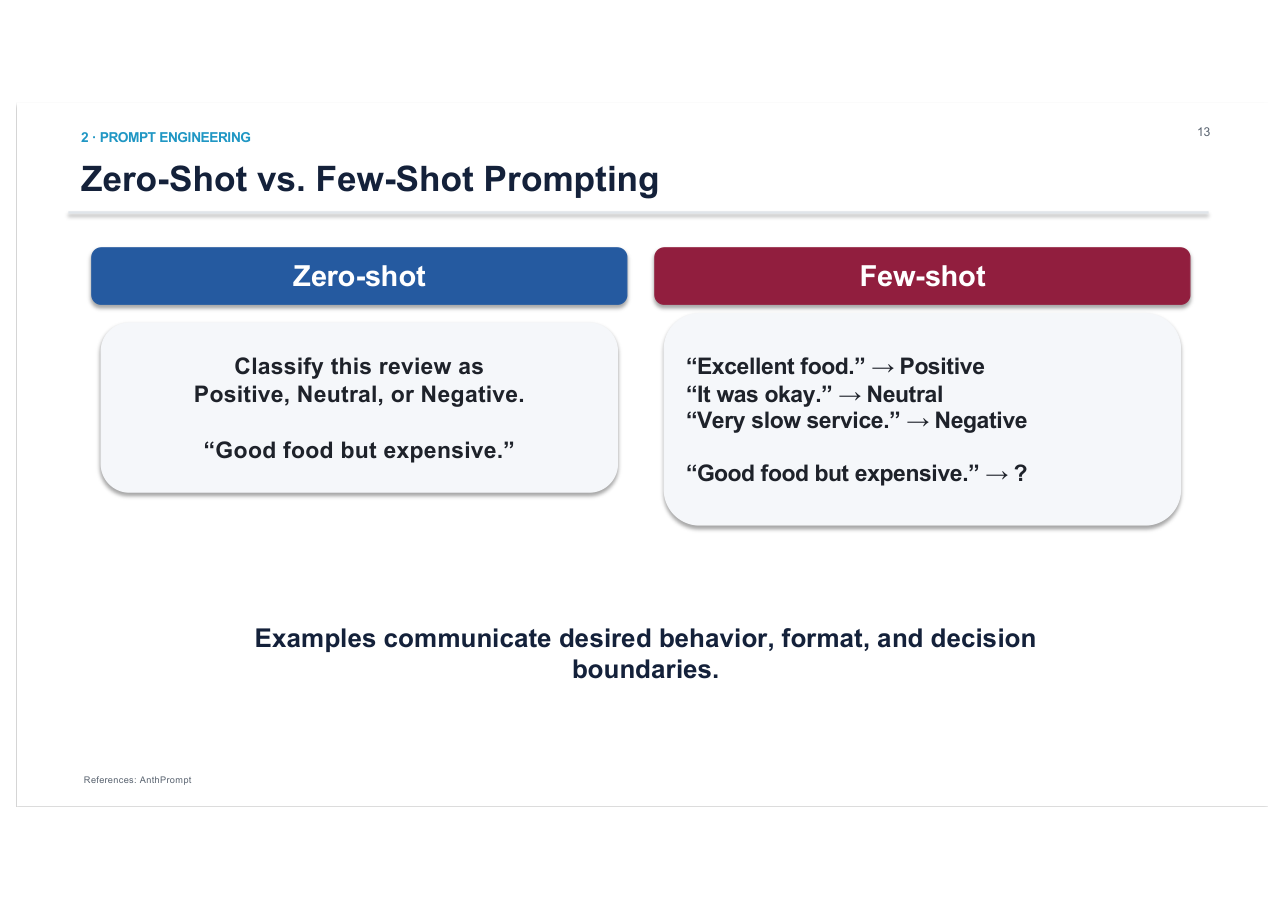
Few-shot คือการให้ตัวอย่างใน prompt ให้โมเดลเดาได้ตรงขึ้นว่าควรตอบ positive, neutral หรือ negative
Structured output และแตกงาน
- Structured output (JSON schema) สำคัญเมื่อผลลัพธ์ต้องป้อนต่อให้ API, pipeline หรือ agent (สไลด์ 36)
- Decomposition: แตกคำถามยาก ("ทำไมยอดขายตก") เป็นขั้น: ระบุ metric → เทียบช่วงเวลา → แบ่งกลุ่ม → หาสาเหตุ → ตรวจหลักฐาน → สรุป (สไลด์ 37) อาจารย์เปรียบว่าสั่งเหมือนสั่งเด็ก ทีละขั้น (1:33:11)
- เทคนิคอื่นที่สไลด์ 38 ระบุ: Chain-of-Thought, Self-Consistency, ReAct อาจารย์อธิบาย self-consistency ว่า "คิดหลายรอบแล้วดูว่าตอบตรงกันไหม" (1:33:50)
ติ๊กส่วนของ ICIO เข้า/ออก ดู prompt ที่ประกอบเสร็จและคุณภาพคำตอบที่คาดได้
ทำไม "Analyze this." เป็น prompt ที่แย่
ขาดทั้ง context, ข้อมูลที่จะวิเคราะห์ และรูปแบบ output → ผลลัพธ์กว้างและเดาไม่ได้ ควรระบุ Instruction + Context + Input + Output
Prompt ที่ดีที่สุดก็ไม่ทำให้ LLM รู้ข้อมูลที่ไม่เคยเห็น (เช่นข้อมูลภายในบริษัท) นั่นคือปัญหาที่ RAG แก้ในบทถัดไป
5ลองทำ
- Anthropic: Prompt engineering overview แหล่งที่สไลด์อ้าง (AnthPrompt)
- Hugging Face LLM Course ภาพรวม LM และ transformer
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย