Lesson 07 · คาบบ่าย 28 ต.ค. (วิดีโอ 0:25–0:58) · ~25 นาที
ตระกูล DL และงานภาพ: classify, detect, segment
1ตระกูลของ Deep Learning
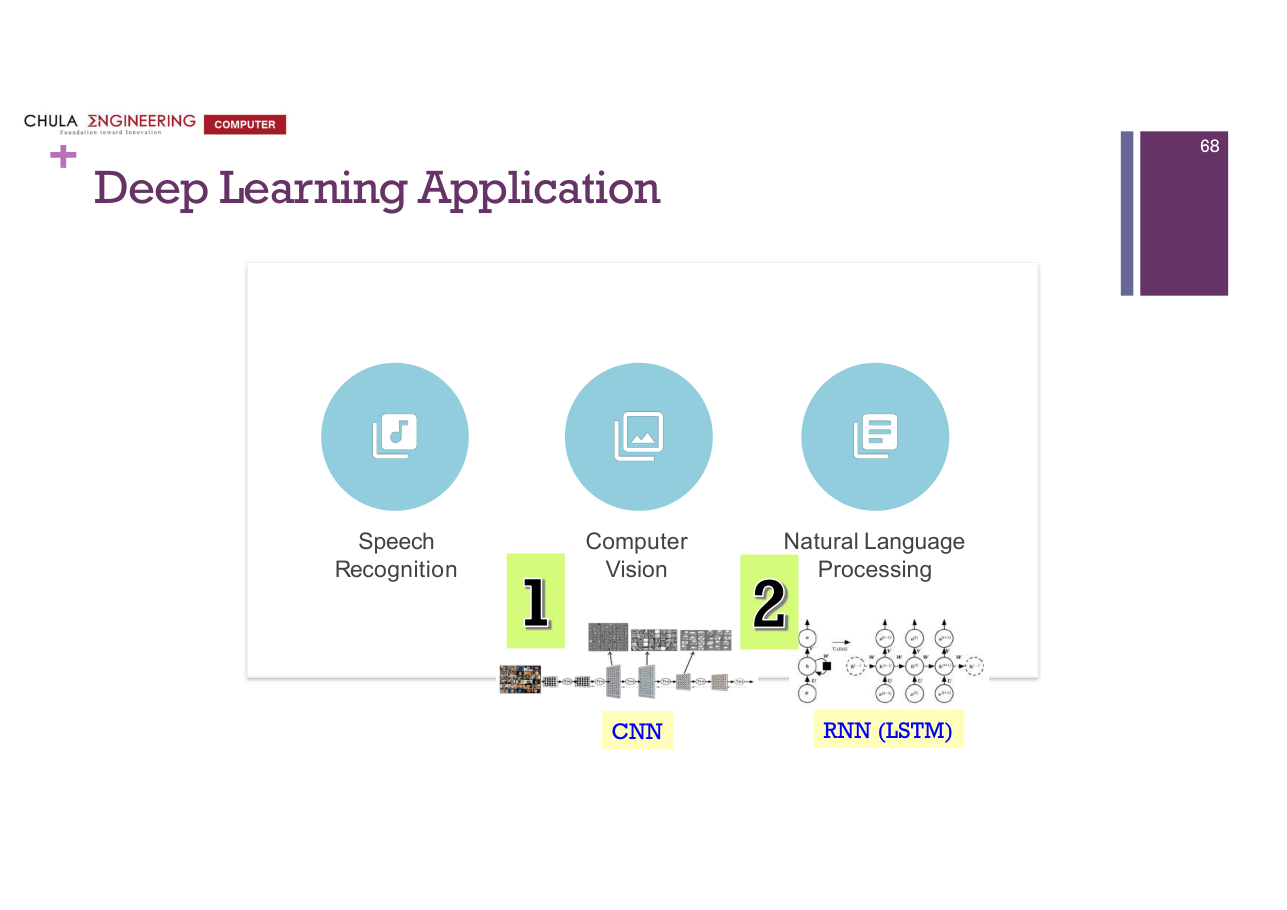
convolution ถูกออกแบบมาสำหรับข้อมูลแบบไหน? ภาพ ส่วนข้อมูลแบบอื่นจึงมีตระกูล DL อื่น แต่ ทุกตระกูลผลลัพธ์สำคัญคือ embedding vector
| ตระกูล | เหมาะกับ | หมายเหตุ |
|---|---|---|
| CNN | ภาพ | conv + pooling (บท 5) |
| RNN / LSTM | ข้อมูลเรียงลำดับ: time series (10, 20, 30 → ?), เสียง, NLP รุ่นก่อน | ไม่ลงรายละเอียด ไม่มี conv |
| Transformer (2017) | ทุกงาน (แปลภาษา, text, ภาพ, ...) | โครงสร้างหลักของ LLM |
Transformer เกิดปี 2017 ทำให้ RNN โดนตบคว่ำ มันมี attention (เข้าใจความสัมพันธ์ของข้อมูลทั้งชุด) และออกแบบมาให้ทำได้ทุกงาน
Transformer: Encoder และ Decoder
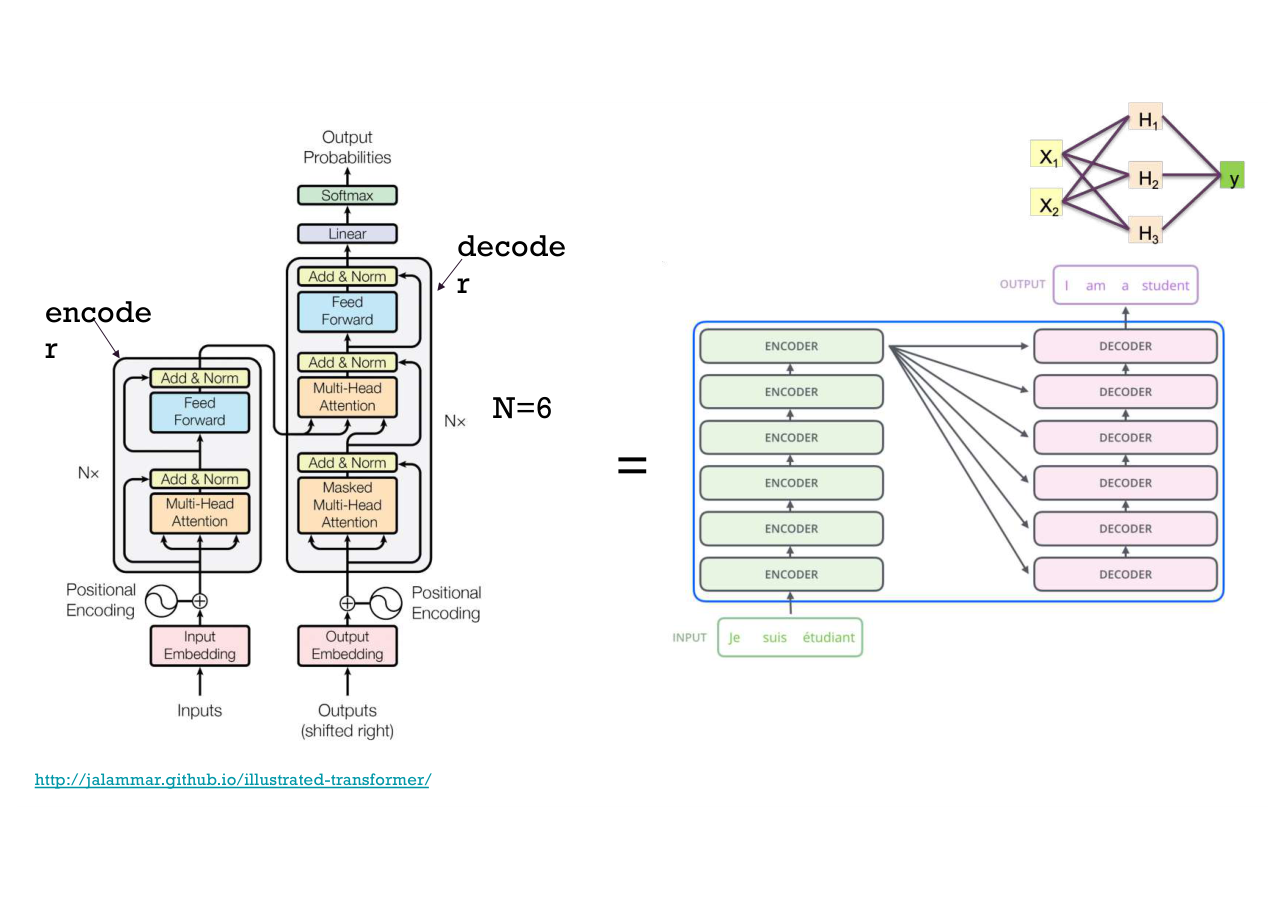
Transformer ออกแบบมาแปลภาษา: ฝั่ง Encoder แปลงข้อความต้นทางเป็นเวกเตอร์ (embedding) ฝั่ง Decoder เอาเวกเตอร์ไป decode/generate เป็นคำตอบ (เช่น คำแปล)
Full transformer ใหญ่จัด จึงแตกเป็นสองสาย: Google หยิบเฉพาะ Encoder ทำ BERT (2018) ส่วน OpenAI หยิบฝั่ง Decoder (generator) ทำ GPT
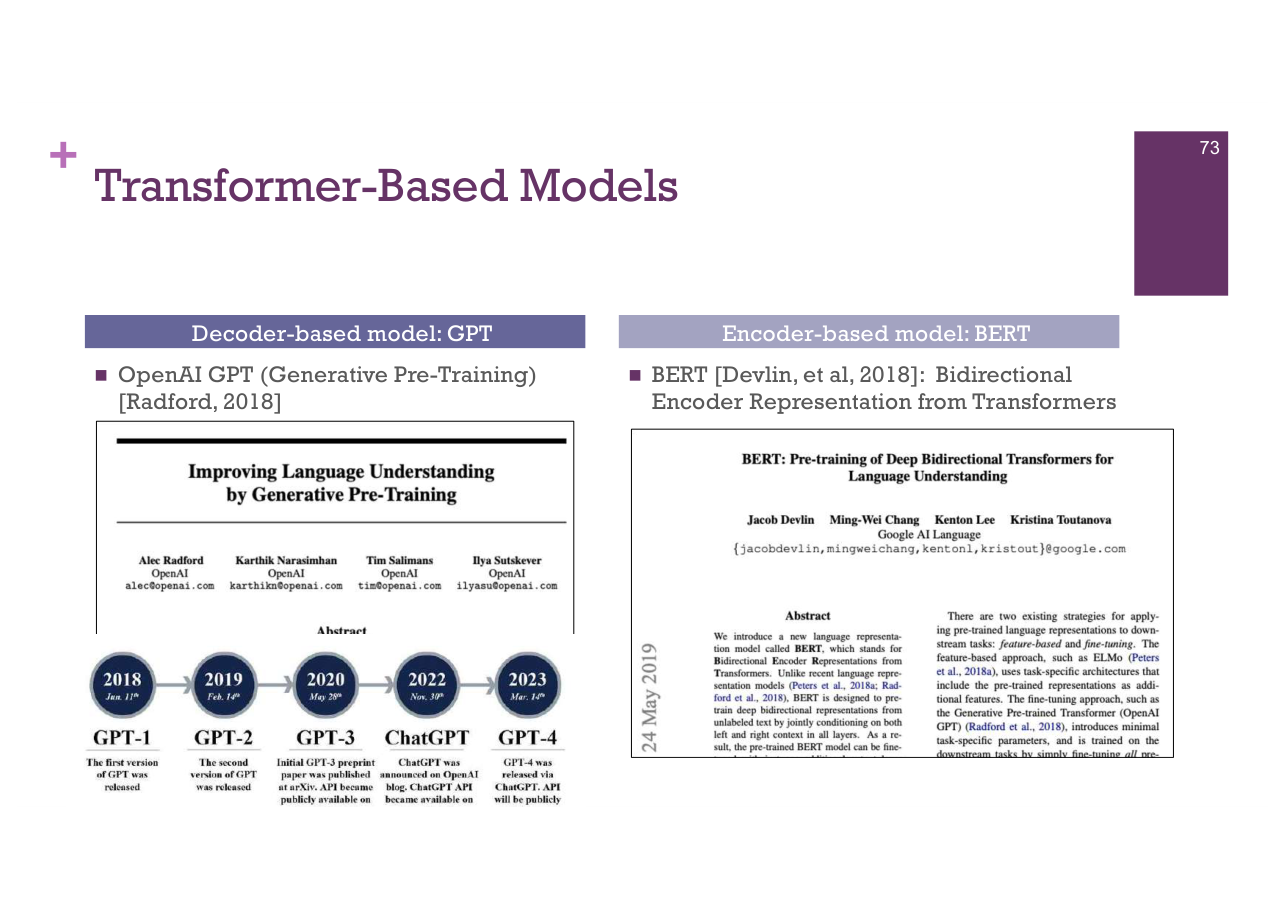
- BERT = Encoder-only: ได้ embedding ของข้อความ (เหมาะกับค้นหา/จัดกลุ่ม/จำแนก)
- GPT = Decoder-only: เจนข้อความ (เป็นฐานของ ChatGPT, ดูบท 8)
Transformer ใหญ่กว่า CNN มาก (0:36:14) ถ้าโจทย์เรียบง่ายอย่าเลือก Transformer เพียงเพราะมันทันสมัย
2งานภาพ 3 ประเภท
งานภาพมี 3 ประเภท: (1) Classify บอกว่าทั้งภาพคือภาพอะไร (2) Object detection ตีกรอบ (3) Semantic segmentation ไฮไลต์เป็นพื้นที่
ภาพเดียวกัน สามงานให้ output ต่างกัน สลับดูได้
1) Image classification
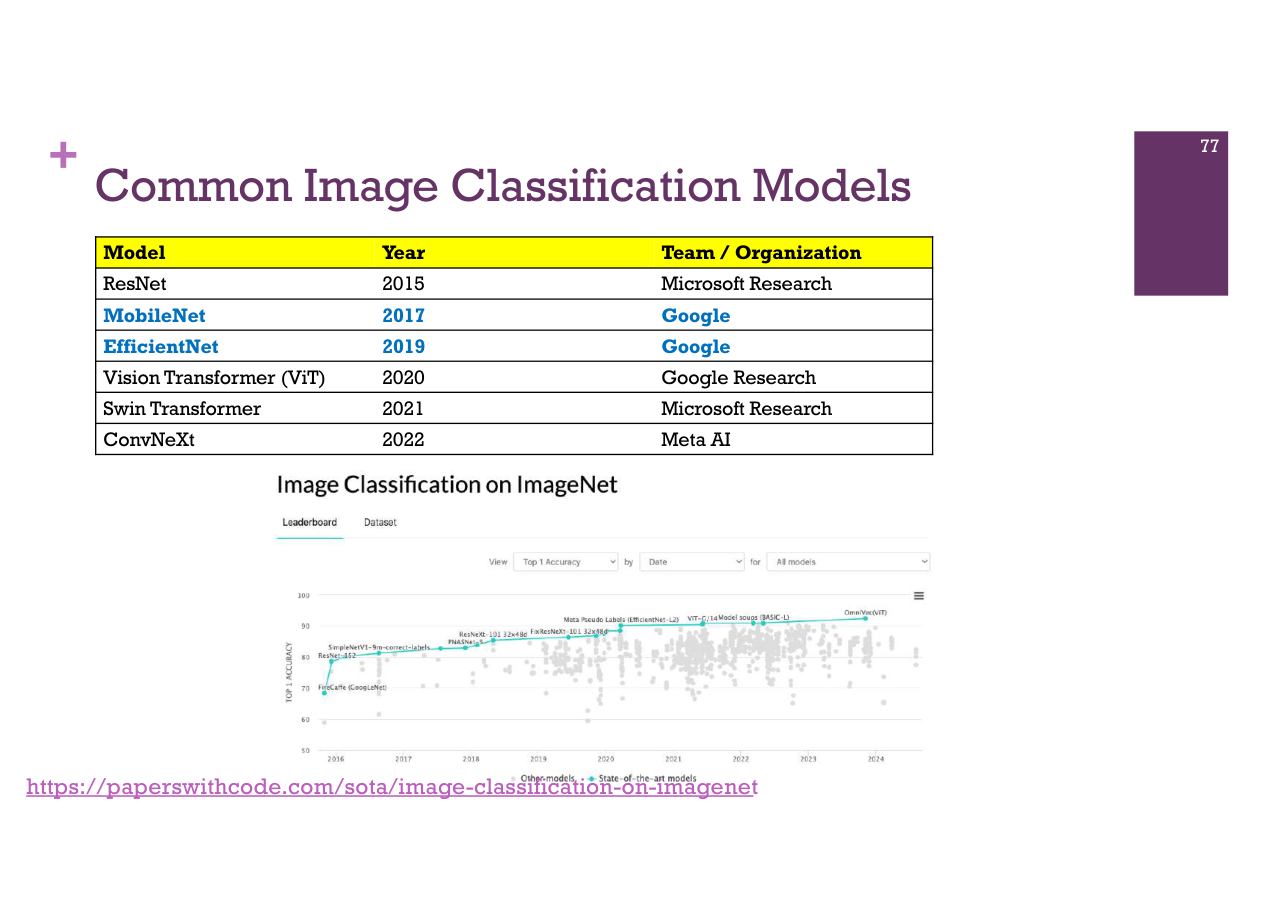
อาจารย์เทียบตระกูล CNN 3 ตัว: EfficientNet เก่งสุดแต่ใหญ่กว่า (เหมือน random forest) ResNet ง่าย/เล็กกว่า (เหมือน decision tree) MobileNet เบามาก ติดตั้งบนมือถือได้
2) Object detection
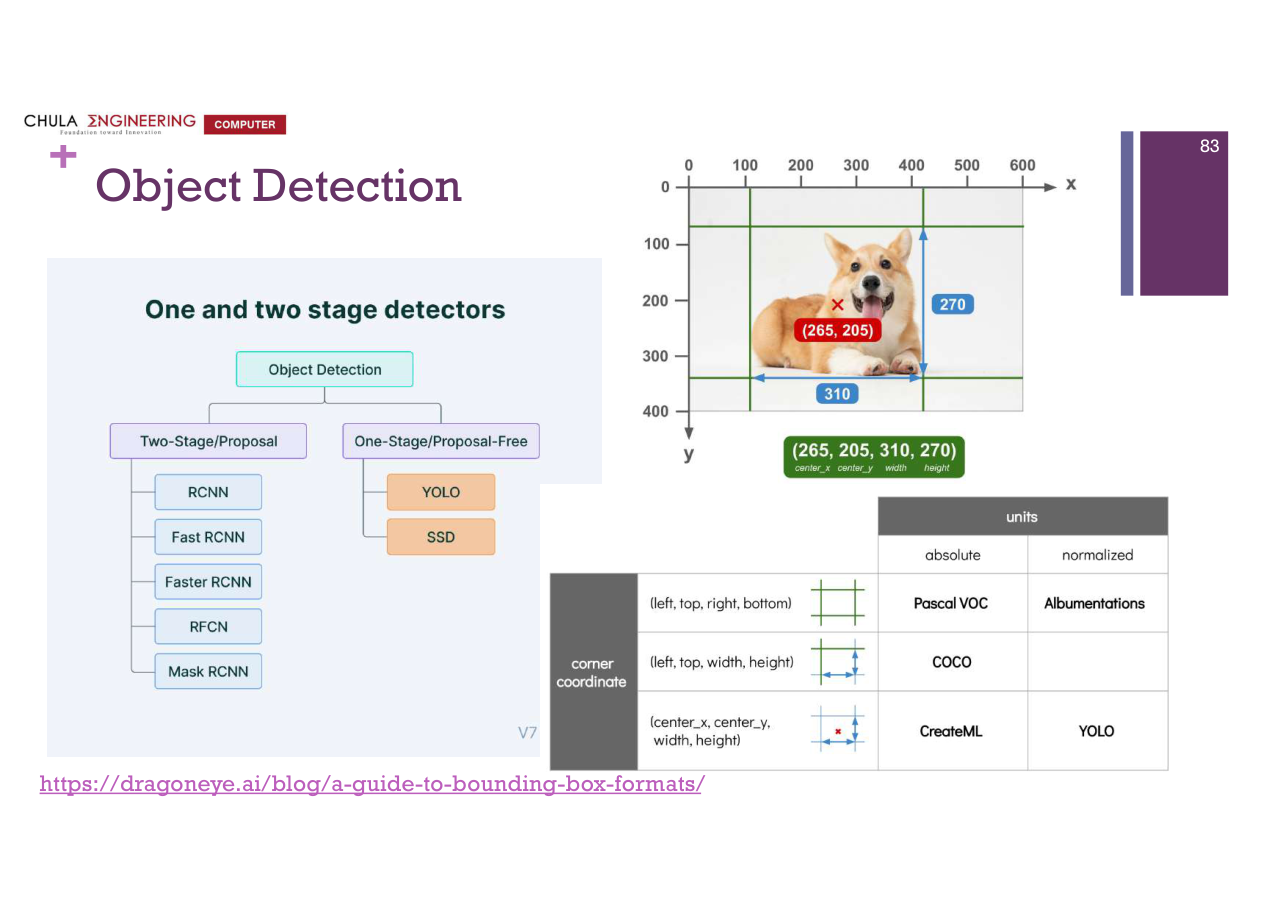
output (label) คือ x, y, w, h ของกรอบ พร้อมบอกว่า คลาส ของกรอบ ต้องสอนด้วยข้อมูลที่มีกรอบและคลาส
- YOLO (You Only Look Once): one-stage, ดูครั้งเดียวได้ทั้งกรอบและคลาส เป็นตระกูล CNN จึงเล็กและเร็ว ติดบนกล้อง/ชิปได้ (0:49:49) ครองตลาดอยู่
- YOLO เป็นชื่อกลางของตระกูลโมเดล ไม่ใช่ของบริษัทเดียว (เหมือน iOS ของ Apple แต่ YOLO ไม่ได้มาจากเจ้าเดียว) YOLO ของ Ultralytics ใช้ง่ายที่สุด: v5 (2020) → v8 (2023) → 11 (2024) → 26 (2026)
- ตระกูล Transformer: DETR (Detection Transformer) และ RT-DETR (real-time) ใหญ่กว่า (0:53:42)
YOLO pretrain ด้วย COCO ถ้าโจทย์ไม่ต่างมาก (คนข้ามถนน ฯลฯ) ไม่ต้อง fine-tune backbone แค่เทรนหัว แต่ถ้าเป็นวัตถุที่ COCO ไม่มี ต้อง fine-tune ลึกถึง backbone
3) Semantic segmentation
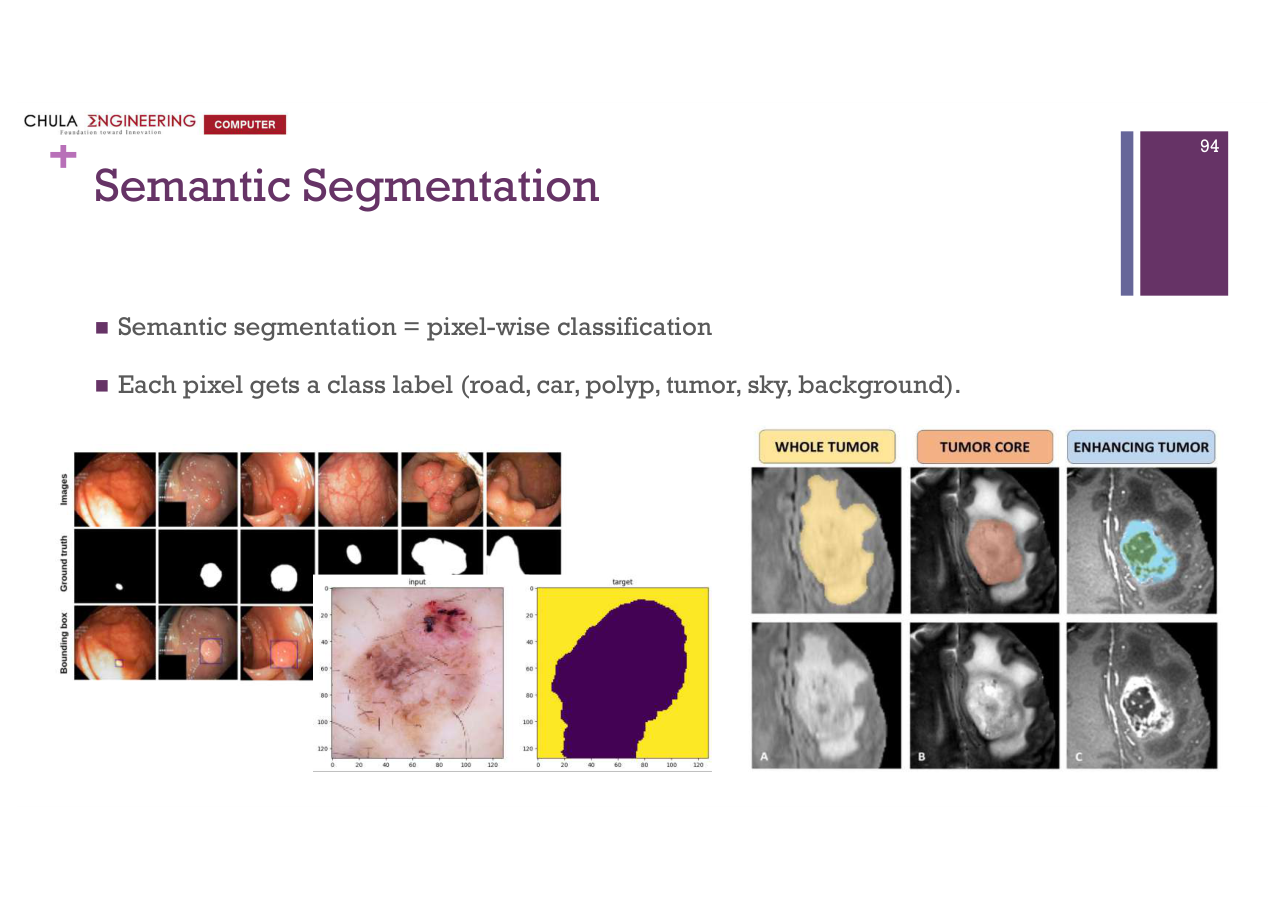
- ไม่ใช่กรอบ แต่ ไฮไลต์เป็นพื้นที่ (region) ของวัตถุ จัดประเภททุกพิกเซล (เช่น ติ่งเนื้อ, มะเร็งผิวหนัง)
- โมเดลที่นิยม: U-Net (encoder-decoder, ส่ง feature ข้ามจาก encoder ไป decoder ด้วย skip connection)
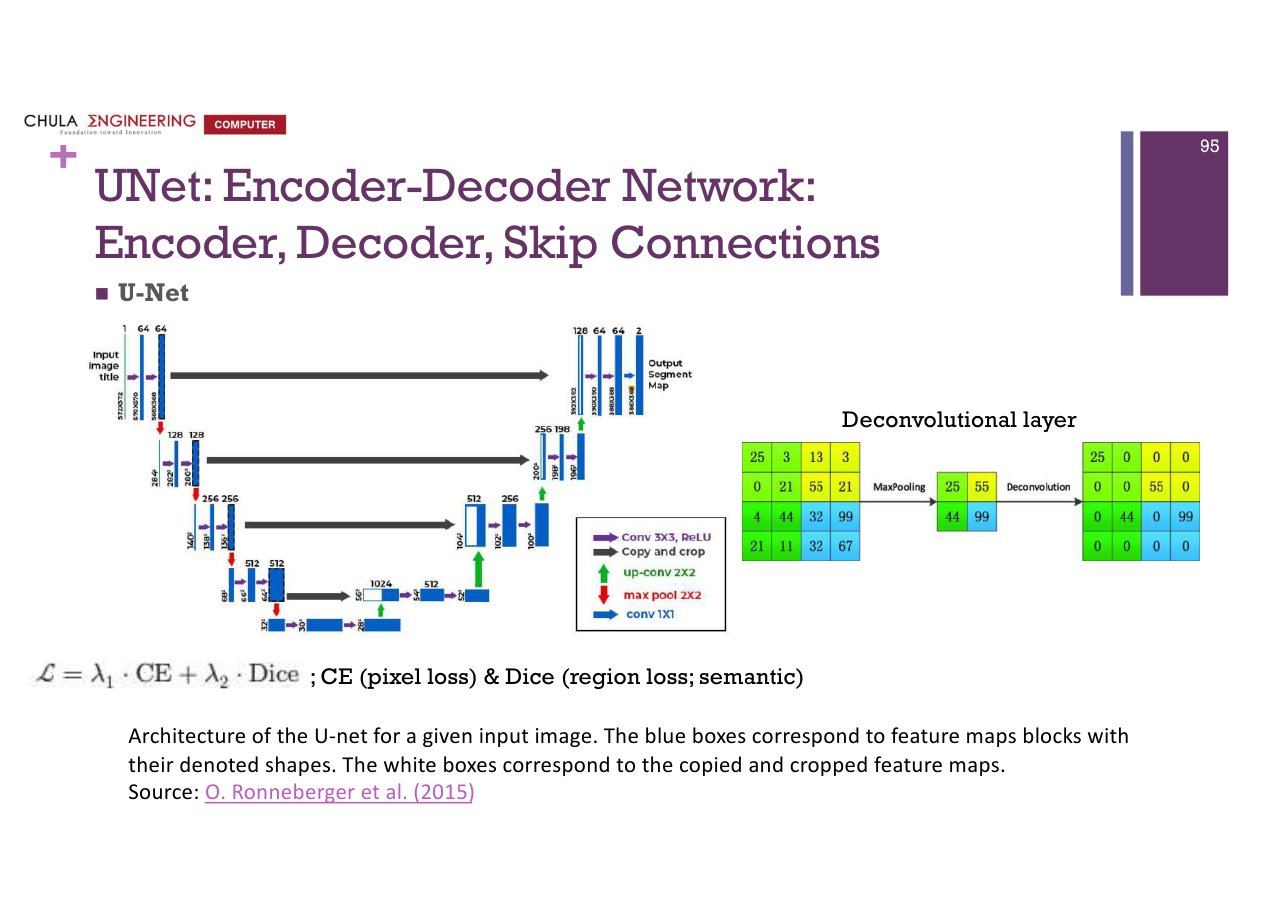
ถ้าไม่อยากใช้ U-Net ก็ใช้ YOLO รุ่น segmentation (modify หัวนิดหน่อยให้เหมาะกับ segmentation) ก็ได้
อาจารย์ย้ำเรื่องโปรเจกต์: จะ ประกาศวันอังคารหลังสอบ เกี่ยวข้องกับ object detection ที่เหลือเป็นความคิดสร้างสรรค์ ไม่ได้จำกัดว่าต้องใช้โมเดลไหน
3ลองทำ
- Ultralytics YOLO docs ใช้งาน YOLO detect/segment และรูปแบบ label
- U-Net paper (Ronneberger et al. 2015) ต้นฉบับ U-Net
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย