Lesson 06 · คาบบ่าย 28 ต.ค. (วิดีโอ 0:04–0:47) · ~25 นาที
Pretrained model และ Fine-tuning
- ตัวอย่างสัตว์บกหรือสัตว์น้ำ → transfer ความรู้จากอดีต
- ความหมายของ pretrained model
- fine-tune = โหลด pretrained weight
1ทำไมไม่เริ่มจากศูนย์
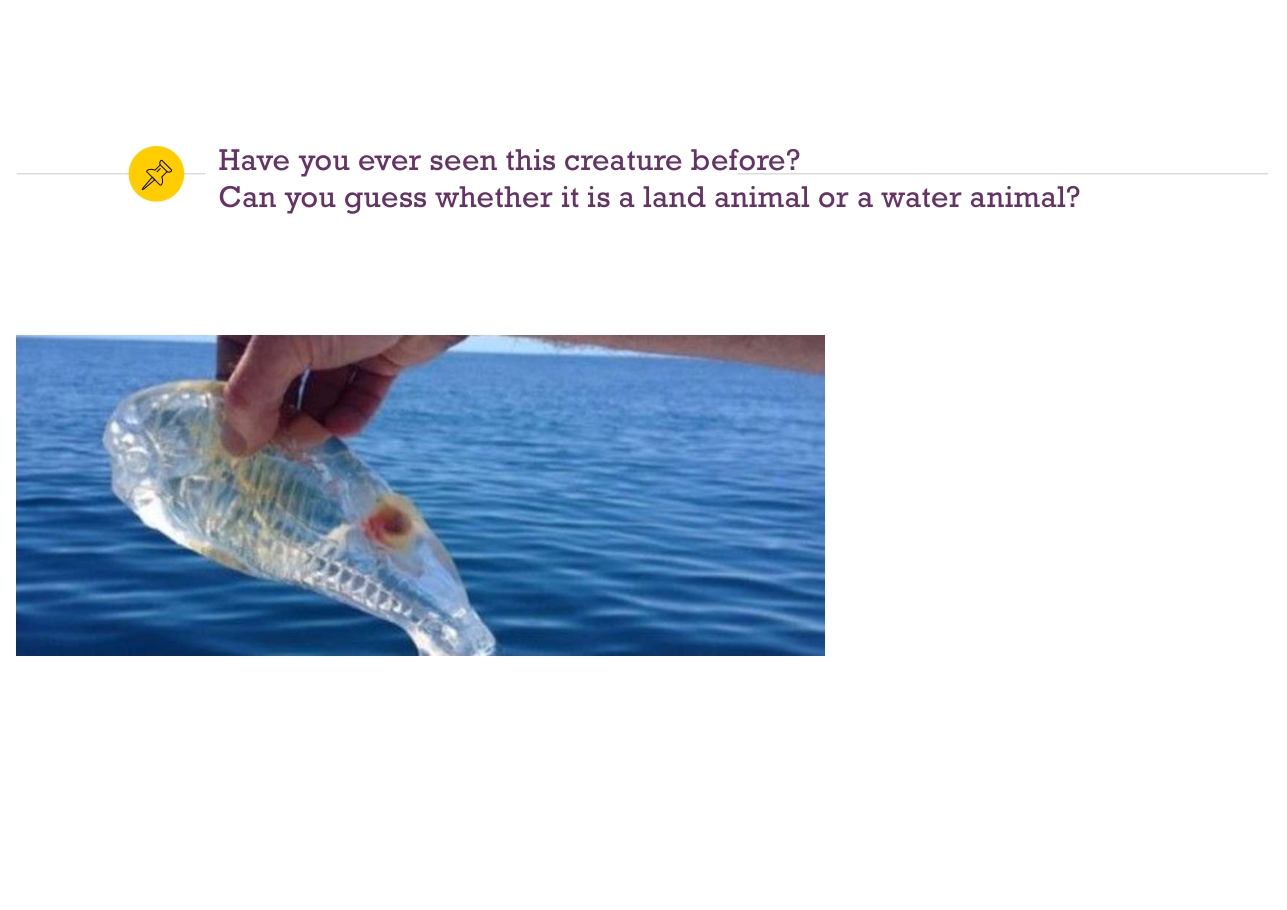
เราบอกได้ว่าเป็นสัตว์น้ำเพราะมีความรู้เดิมว่าสัตว์บกต้องมีขา ไม่ใช่หางแบบนี้ นี่คือ transfer knowledge จากอดีต ไม่ได้เริ่มจากศูนย์
Deep learning หนึ่งตัวมีพารามิเตอร์ ~144 ล้านตัว ถ้าเทรนให้ดีต้องมีภาพเป็นแสนเป็นล้านรูป ซึ่งในงานจริงของเราไม่มีให้
การเทรนจากศูนย์ (from scratch) คือสุ่ม weight เริ่มต้น ส่วนผลลัพธ์ของการเทรนคือ weight = ความรู้
โมเดลที่ถูกเทรนมาก่อนแล้วกับข้อมูลปริมาณมหาศาล (เช่น ImageNet 14 ล้านรูป 1,000 คลาส) เราดาวน์โหลด weight ตั้งต้นมาต่อยอด เรียกว่า fine-tune = Pretrained model + เทรนเพิ่มกับงานใหม่ ข้อดีคือข้อมูลและเวลาน้อยลง
ImageNet มี 14 ล้านรูป เคยเห็นหมามาก่อนแน่ ๆ รถกระบะก็เห็นมาแล้ว ความรู้เรื่องเส้น ขอบ ท่าทาง ติดมาแล้วในชั้น conv จึงไม่ต้องเริ่มใหม่
2ทำอย่างไรเมื่อจำนวนคลาสเปลี่ยน
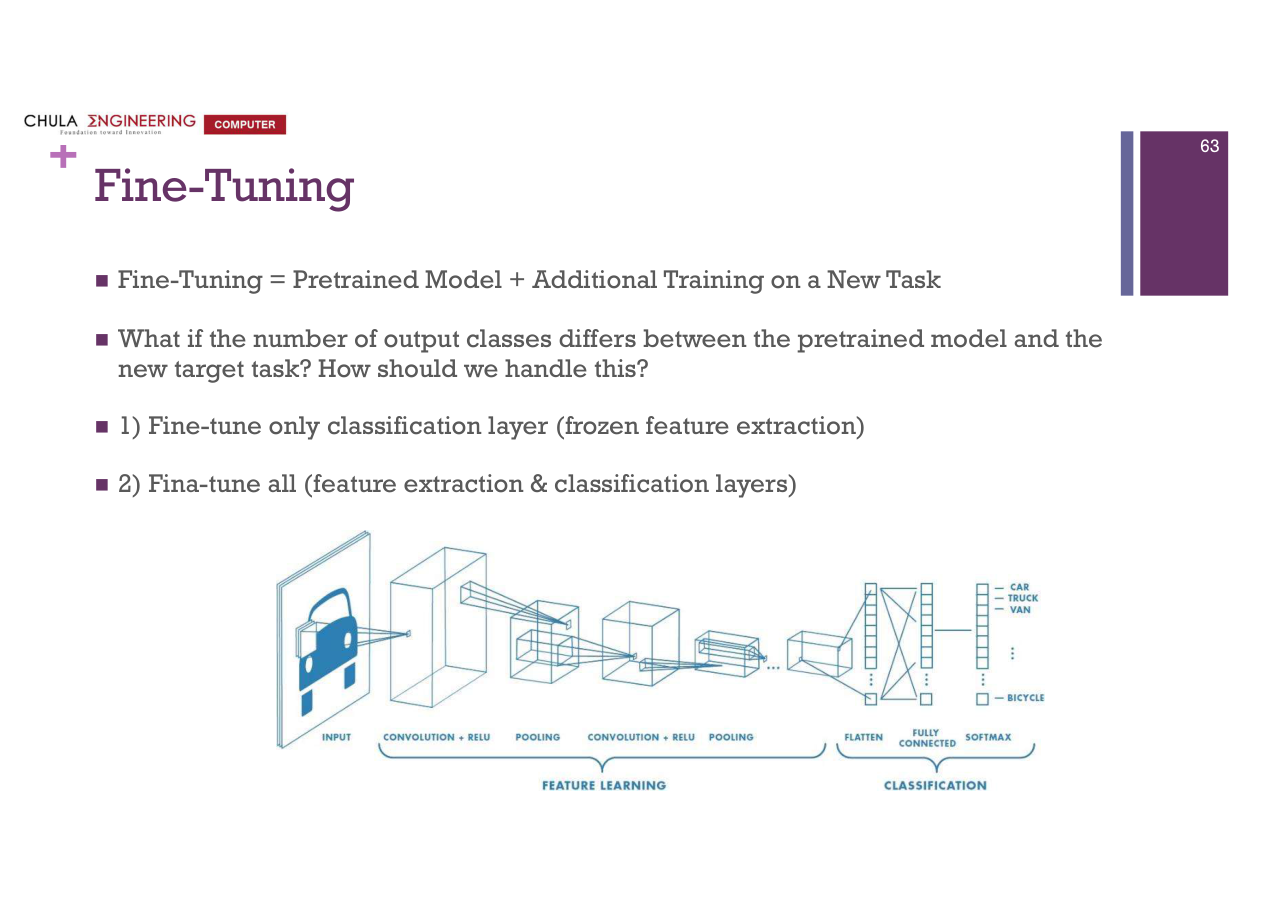
โมเดลเดิมถูกเทรนให้ตอบ 1,000 คลาส แต่งานเราอาจมีแค่ 2 คลาส (หมา/แมว) → ต้องตัด output layer เดิมแล้วต่อ "หัว" (head) ใหม่ของเราเอง
| ท่า | ทำอะไร | ใช้เมื่อ |
|---|---|---|
| 1. Freeze + เทรนเฉพาะ head | ล็อก weight ส่วนสกัดฟีเจอร์ไว้ เทรนแค่ output layer | ข้อมูลของเราคล้ายข้อมูลที่ pretrain มา (general) · เบา เร็ว ไม่ต้อง back-prop ทั้งโมเดล |
| 2. Fine-tune ทั้งหมด | ปรับ weight ทั้ง feature extractor และ head | ข้อมูลต่างจากที่ pretrain มากหรือมีข้อมูลมากพอ (เช่น ภาพแพทย์) |
| 3. Zero-shot | ไม่เทรนเลย เรียก API โยนรูปถาม | โมเดลใหญ่มาก (เช่น foundation / VLM) |
ท่าที่ 1 คือ fine-tune เฉพาะ classification layer ถ้าข้อมูลของเราไม่ได้ต่างจาก general data ที่เทรนมามากนัก ก็ไม่จำเป็นต้องอัปเดตทั้งหมด
ทำไมอยากทำท่าแรก: เบากว่า ไม่เสียเวลา back-prop ไปทั้งโมเดล ในโค้ดตัวอย่างอาจารย์ถามว่ามีการคำนวณ gradient และอัปเดต weight ไหม คำตอบคือมีเฉพาะที่หัว
สรุปให้จดไว้ 3 รูปแบบ: (1) หยิบโมเดลมาเทรน (CNN หรือ ViT ที่ไม่ใหญ่มาก) จะเทรนแค่หัวหรือทั้งหมดก็ได้ (2) ทางสายกลาง: freeze ตัวใหญ่ที่เก่งแล้วใช้สกัดฟีเจอร์ แล้วเทรนหัวเอง (3) โมเดลใหญ่มากจน zero-shot ได้ เรียก API โยนรูปถามได้เลย
ลองสลับท่า ดูว่า layer ไหนถูกล็อก เทรน หรือสุ่มเริ่มต้น และสัดส่วน weight ที่ต้องอัปเดต
3ทางสายกลาง: โมเดลที่ใหญ่เกินไปจะ fine-tune
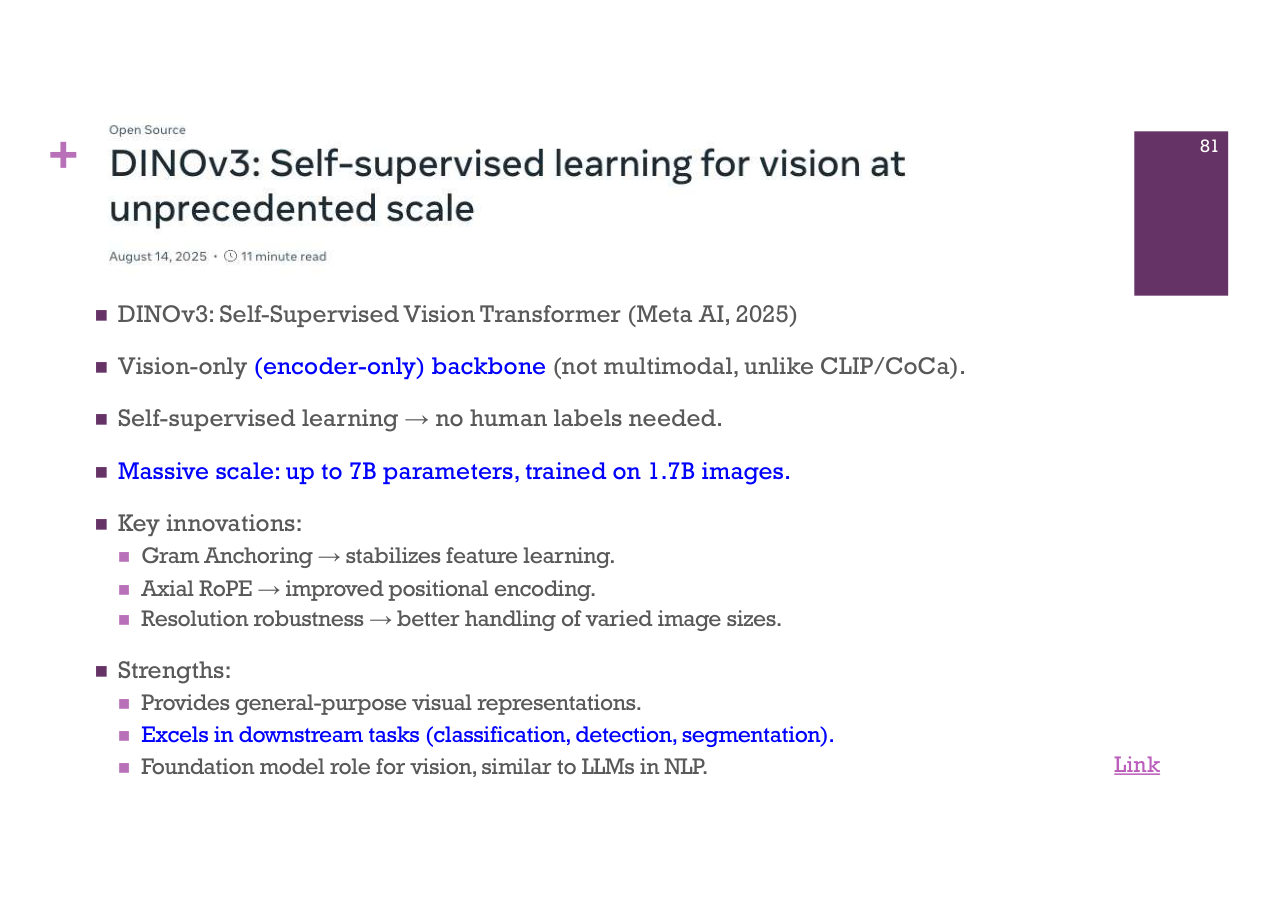
DINO มี 7 พันล้านพารามิเตอร์ เทรนไม่ไหว เก่งเพราะเห็น 1.7 พันล้านรูป (Meta มีข้อมูลทั้งโลก) จึง ไม่มีใคร fine-tune แล้ว ใช้ DINO เป็น encoder สกัด embedding แล้วเทรนแค่หัวที่เราต่อเอง
อาจารย์ใบ้ว่า DINO เป็น self-supervised (ไม่ต้องใช้ label ในการ pretrain) ถ้าต้องการเทรนเอง ให้เลือกโมเดลที่เล็กที่สุดในตระกูล (เช่น CNN เล็ก ๆ) ถ้าเงินเยอะ ไม่อยากเทรนก็ใช้ zero-shot ผ่าน API
4โหลด pretrained มาใช้จากไหน
Hugging Face คล้าย GitHub สำหรับโมเดล: เรา publish repo แล้วแชร์ได้ โมเดลก็แชร์เป็นเพจได้ ในโค้ดสมัยใหม่ ไม่ต้องต่อโครงเอง เรียกชื่อโมเดล เช่น EfficientNet ข้างหลังต่อโครงไว้เสร็จแล้ว (วิดีโอ 0:21:36 โค้ดตัวที่สองใช้ pretrained จาก Hugging Face)
อาจารย์ถามเรื่อง weight ที่เลือกว่า pretrain จากข้อมูลอะไร ถ้าเป็น ImageNet ก็เป็นข้อมูลทั่วไป ถ้าโจทย์เราเป็นภาพแพทย์ ควรเลือกโมเดลที่ pretrain มากับข้อมูลทางการแพทย์
ถ้าโหลด weight ที่ pretrain ด้วยข้อมูลแพทย์ มันก็จะเก่งเรื่อง medical data แล้วอาจเอาไป fine-tune ต่อกับข้อมูลของเราอีกที
ไม่ควรเลือกโมเดลจากขนาดอย่างเดียว ต้องดูด้วยว่า pretrain มาจากข้อมูลโดเมนไหน (ย้ำอีกครั้งในบท LLM ที่ MedGemma / WeatherNext)
การบ้านที่อาจารย์สั่ง: อ่านโค้ด self-study 1 และ 2.1/2.2 สรุปส่งใน MyCourseVille ในห้องสอบไม่ออกเขียนโค้ด DL แต่ใช้ในโปรเจกต์ (วิดีโอ 0:23:04)
5ลองทำ
- PyTorch: Transfer Learning Tutorial ตัวอย่างโค้ด freeze vs fine-tune
- Hugging Face Hub แหล่งโหลด pretrained model
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย