Lesson 05 · คาบเช้า + บ่าย 28 ต.ค. · ~30 นาที
CNN: Convolution, Pooling, Fully-connected
1Image processing: convolution คืออะไร
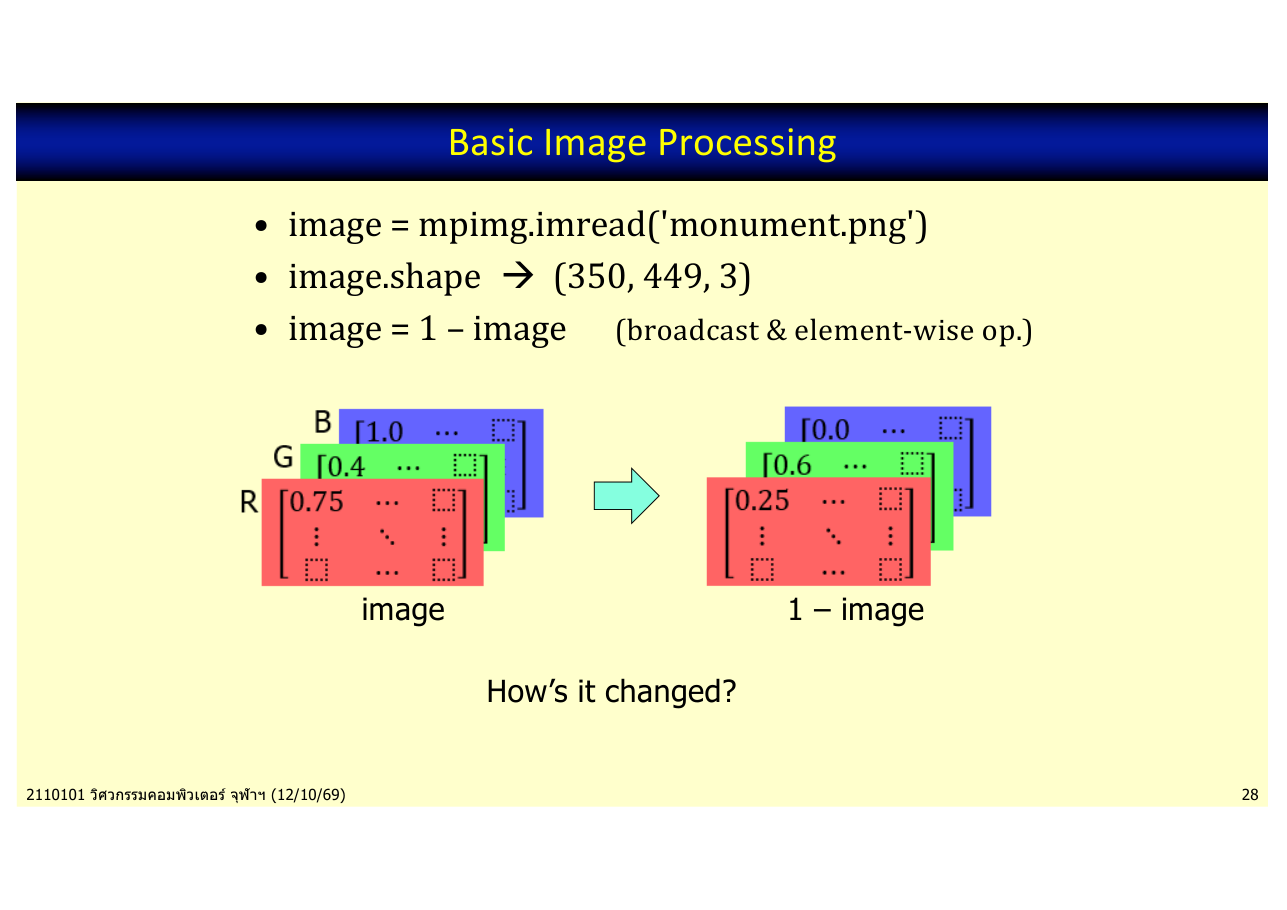
รูปภาพ 1 พิกเซลมี 3 channel (R, G, B) ภาพ \( 350\times449 \) จึงมี shape \( (350, 449, 3) \) ถ้านำ 1 − image จะได้ภาพ negative เฉลี่ย 3 channel ได้ gray scale (ช่วงเช้า ไม่มีไทม์สแตมป์)
Convolution = dot & sum ด้วยแผ่น filter (kernel) แล้วเลื่อนไล่กวาดทั้งภาพ ได้ภาพใหม่
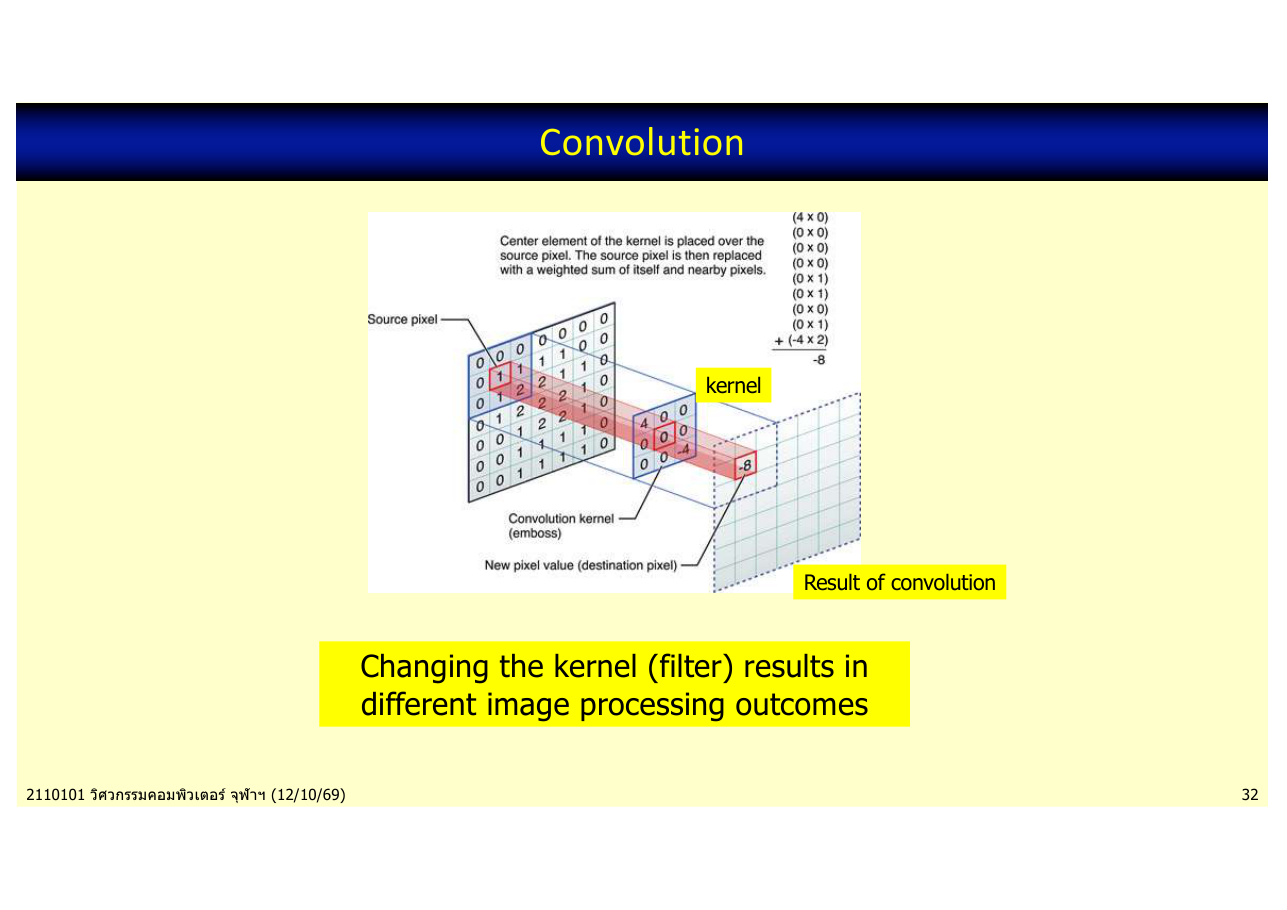
- kernel ที่ทุกช่องเป็น 1/9 → เบลอภาพ
- kernel แบบอื่น → สกัดเส้นขอบ, texture, ซูมอิน ฯลฯ
ปัญหาของวิชา Image Processing: คนต้องไปทดลองออกแบบแผ่น filter เอง ซึ่งไม่มีใครรู้ว่า filter แบบไหนเหมาะกับโจทย์ ("หนึ่ง kernel = สกัดหนึ่งฟีเจอร์ = มองภาพหนึ่งมุมมอง") → ให้โมเดลหาค่าใน kernel เองด้วย back-propagation → นี่คือ CNN
ค่าในแผ่น kernel เป็น weight ที่เรียนรู้จาก back-propagation จากโจทย์โดยตรง จึงเป็นฟีเจอร์ที่ เหมาะกับโจทย์ (เช่นแบ่งหมาแมว)
2ชั้นที่ 1: Convolutional layer (+ ReLU)
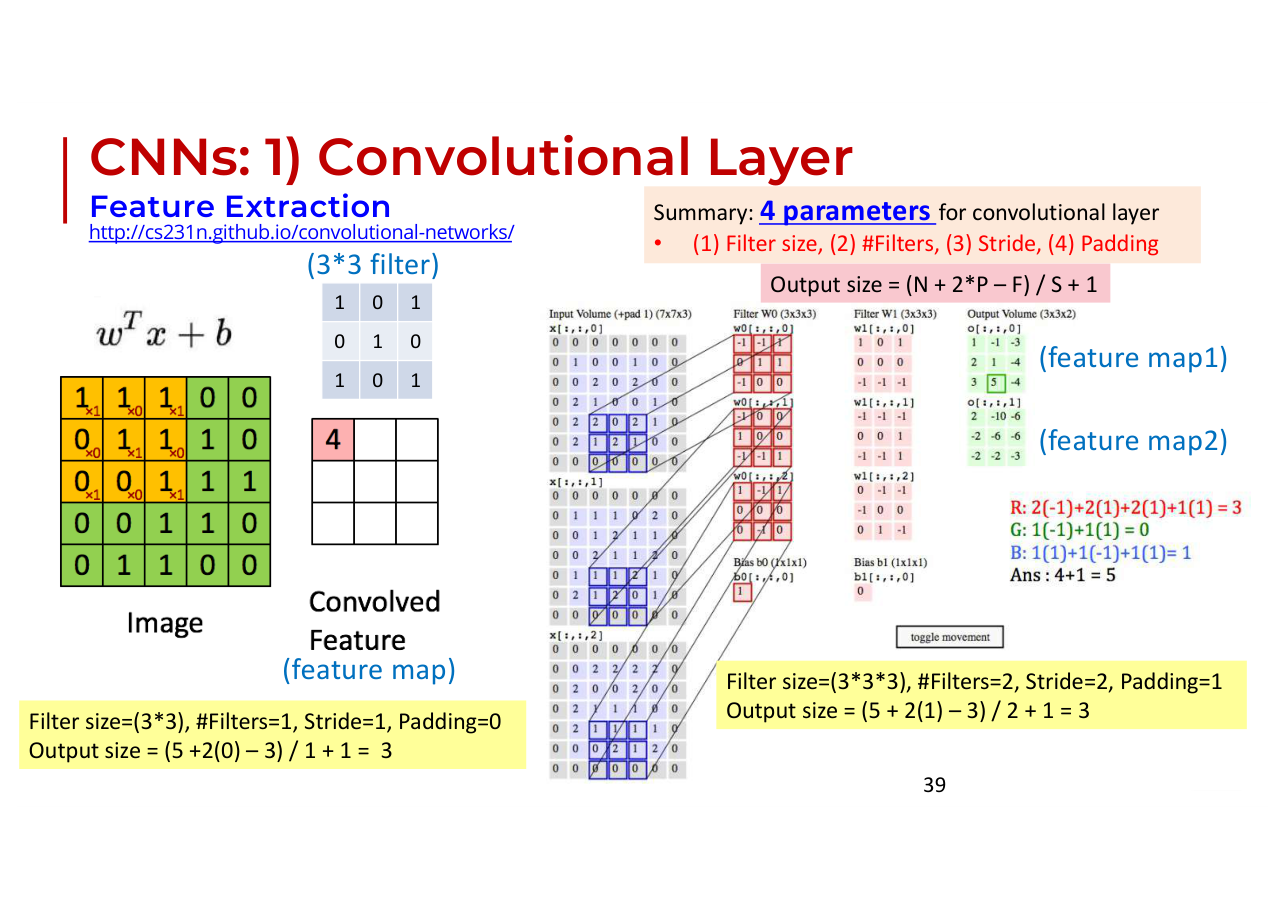
ผู้ใช้กำหนด 4 อย่าง: filter size, #filters, stride, padding
$$ \text{Output}=\frac{N+2P-F}{S}+1 $$ \( N \) = ขนาดภาพเข้า, \( F \) = ขนาด filter, \( P \) = padding, \( S \) = stride
ตัวอย่างในสไลด์
ภาพ \( 5\times5 \), filter \( 3\times3 \), stride 1, padding 0 → \( (5+0-3)/1+1=3 \) ภาพ \( 5\times5 \), filter \( 3\times3 \), stride 2, padding 1 → \( (5+2-3)/2+1=3 \)
ลองไล่ kernel เอง
ภาพ 5×5 กับ kernel 3×3 จากสไลด์ 37 กดทีละขั้นดู dot & sum ของแต่ละตำแหน่ง ช่องสีน้ำเงินคือบริเวณที่ kernel ทับอยู่
- 1 filter ให้ 1 feature map (ภาพใหม่ 1 แผ่น) ใช้ 128 filter ได้ 128 แผ่น
- ต่อด้วย ReLU (activation) เพื่อให้ไม่เป็นเชิงเส้น เพราะ conv เป็นแค่ dot & sum (เชิงเส้น) คล้ายการผสม \( \tanh \) ของ hidden unit ใน Neural Network
อาจารย์เปรียบว่า: Neural Network ที่บอกว่า "ผสมให้หน่อย 3 hidden unit" ก็เหมือนกับ "ให้สกัดฟีเจอร์ด้วย kernel 3 แผ่น"
3ชั้นที่ 2: Pooling layer
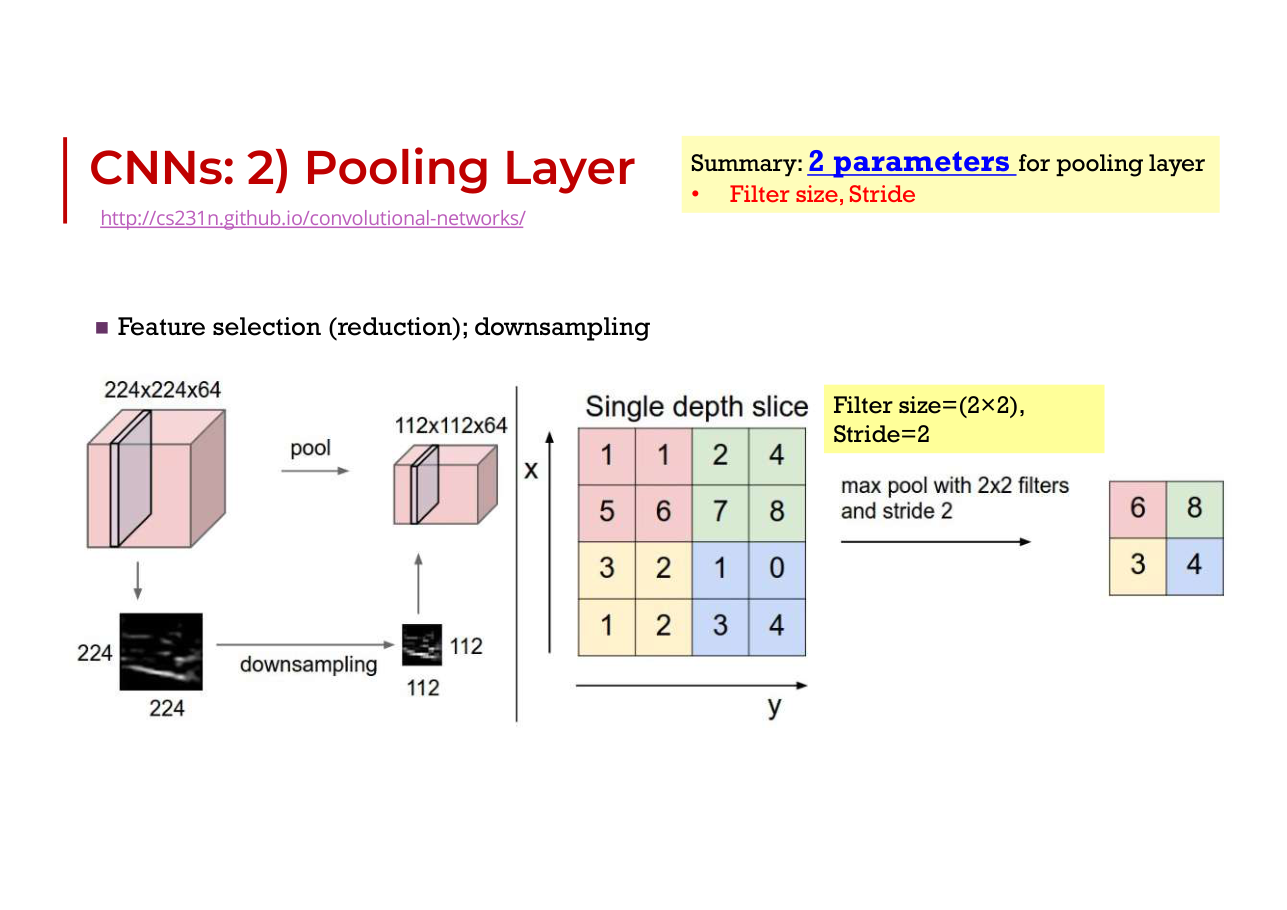
ภาพจริงมีพิกเซลหลายล้านค่า ถ้าสกัด 128 แผ่นโดยไม่ลดขนาด memory จะระเบิด จึงต้องมี pooling เพื่อลดขนาดภาพ Max pooling เลือกค่าเด่นสุดในแต่ละบริเวณ ภาพ \( 4\times4 \) ใช้ \( 2\times2 \) stride 2 เหลือ \( 2\times2 \) (ลดลง 4 เท่า)
พารามิเตอร์ของ pooling มี 2 ตัว คือ filter size กับ stride และ ไม่มีค่า weight ให้เรียนรู้
ลำดับที่อาจารย์ย้ำ: สกัดฟีเจอร์ (conv+ReLU) → ลดขนาด (pool) → สกัดต่อ → ลดขนาด ...
4ชั้นที่ 3: Fully-connected
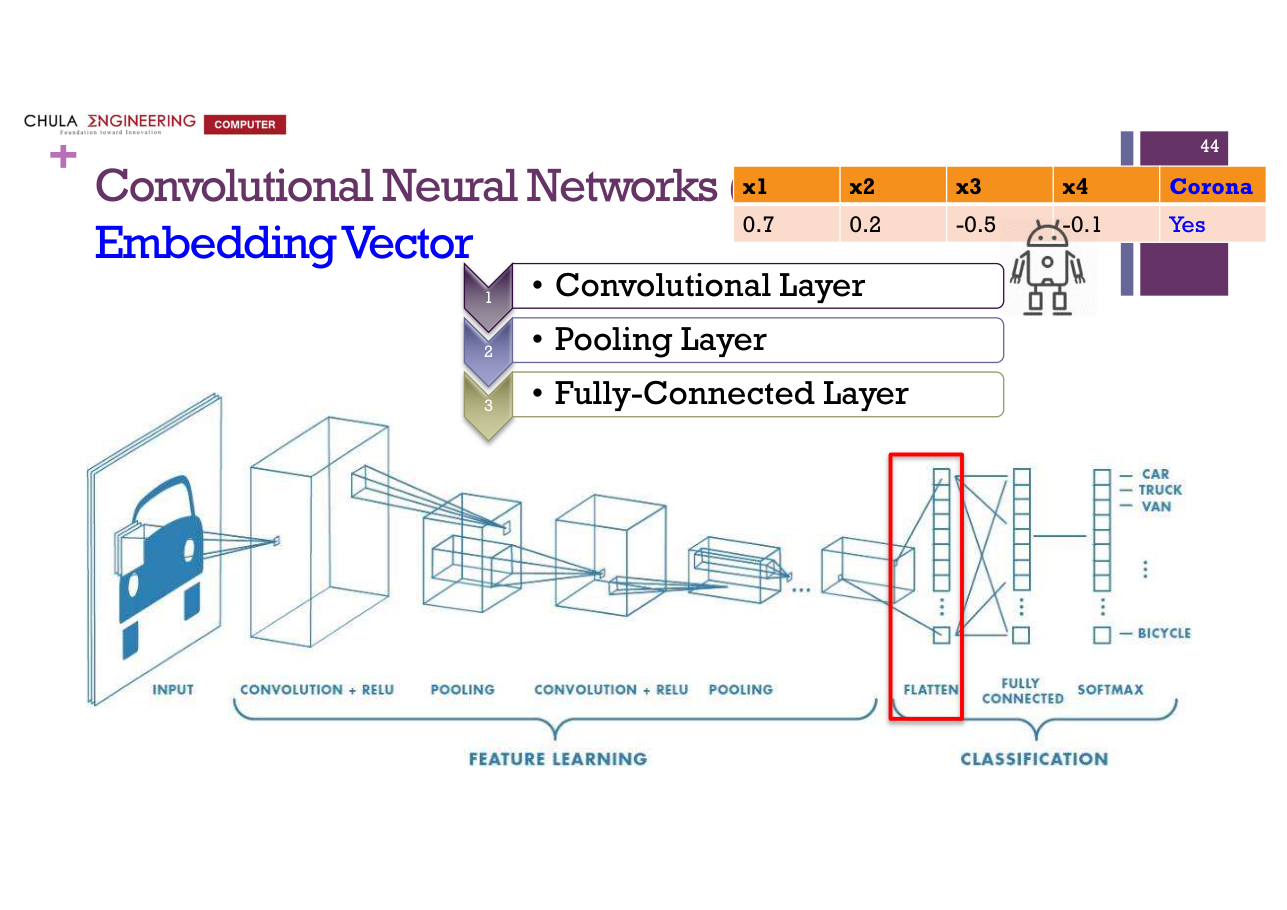
เมื่อเหลือภาพเล็ก ๆ หลายแผ่น (เช่น 2 แผ่น แผ่นละ \( 2\times2 \)) ให้ Flatten เรียงทุกค่าเป็นเวกเตอร์ยาว \( 2\times2\times2=8 \) ค่า นี่คือ embedding vector แล้วส่งเข้า Neural Network ปกติ (Fully-connected layer: hidden layer กี่ชั้นก็ได้) เพื่อทำนายผลลัพธ์
5เลเยอร์ผลลัพธ์ (output layer)
| เงื่อนไข | Output layer | ผลรวม prob |
|---|---|---|
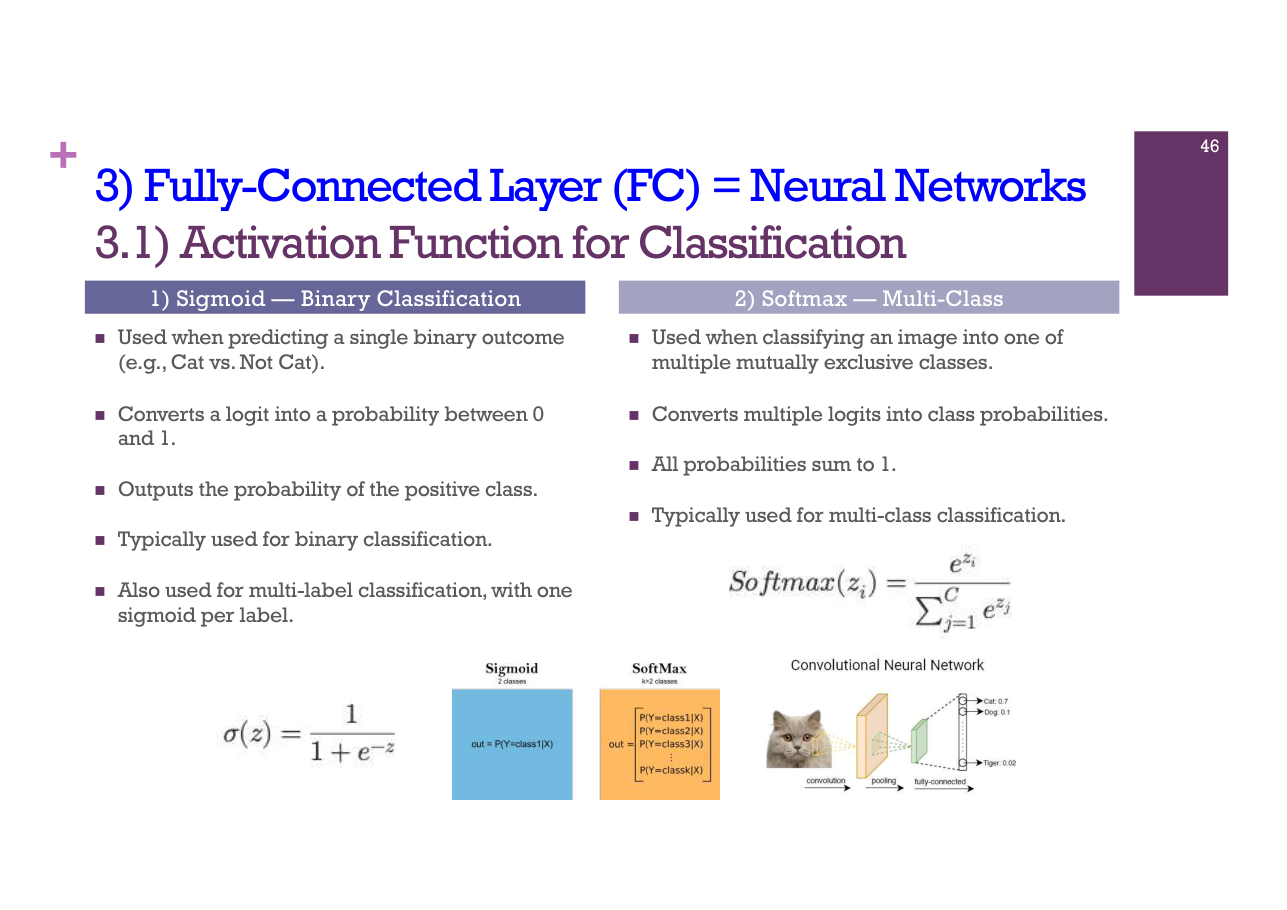
| 2 คลาส (แมว/ไม่ใช่แมว) | Sigmoid แปลง logit เป็น prob ระหว่าง 0–1 | ไม่ต้องรวมเป็น 1 (1 ค่า) |
| หลายคลาสแยกกัน (หมา/แมว/นก) | Softmax | รวมเป็น 1 |
| หลาย label พร้อมกัน | Sigmoid อย่างละหนึ่งตัวต่อ label | ไม่จำเป็นต้องรวมเป็น 1 |
\( \text{sigmoid}(z)=\dfrac{1}{1+e^{-z}} \) และ \( \text{softmax}_i=\dfrac{e^{z_i}}{\sum_j e^{z_j}} \)
Softmax ที่อาจารย์คำนวณมือ
score ของ [แมว, หมา, นก] = [2, 1, 0] \( e^2=7.389,\ e^1=2.718,\ e^0=1 \) ผลรวม 11.107 prob = [0.665, 0.245, 0.090] → ทำนาย แมว (prob สูงสุด) ผลรวม = 1
ลองขยับ score ของแต่ละคลาส ดู prob ที่เปลี่ยน ผลรวมคงเป็น 1 และ loss ของคลาสที่ถูกต้อง
sigmoid ไม่ใช่ "ค่า prob ของทุกคลาสรวมกันเป็น 1" ใช้กับ 2 คลาส ส่วน softmax ใช้กับ multi-class จริง ๆ ที่ไม่ซ้อนกัน อย่าสลับกัน
6Loss และการ back-propagation
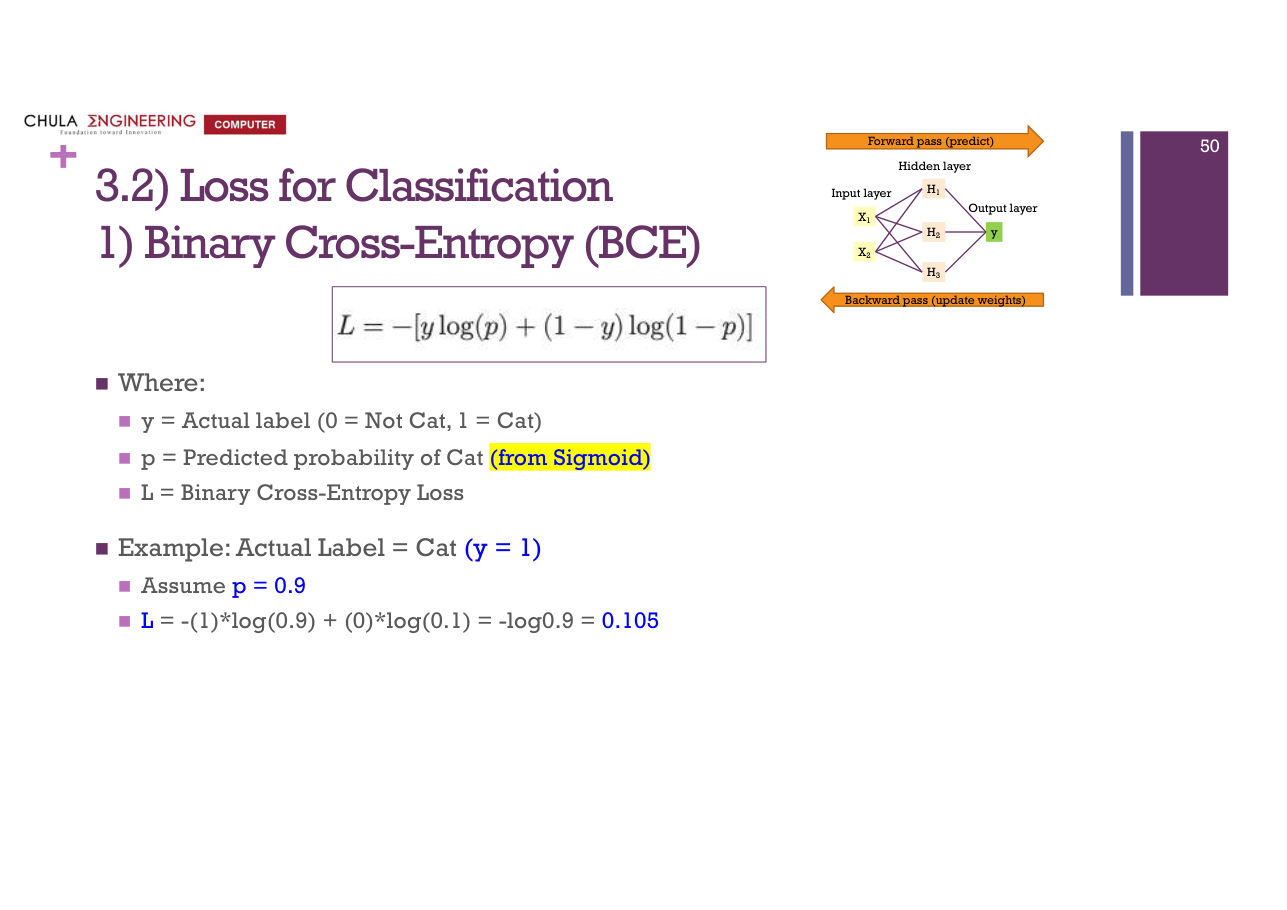
- Binary classification → Binary Cross-Entropy (BCE): \( L=-[y\ln p+(1-y)\ln(1-p)] \)
- Multi-class → Categorical Cross-Entropy (CCE): \( L=-\sum_i y_i\ln p_i \)
อาจารย์บอกว่าไม่ลงสูตรลึก แต่ต้องรู้ว่า: ทำนายเทียบของจริง → ได้ error → เปลี่ยนเป็น loss → loss ส่งกลับ (back-propagation) อัปเดต weight ทั้งส่วน Fully-connected และแผ่น kernel ด้วย
BCE
y = 1 (แมวจริง) p = 0.9 → \( L=-\ln 0.9=0.105 \) (ต่ำ ทำนายดี) ถ้า p = 0.1 → \( L=-\ln 0.1=2.30 \) (สูง ทำนายผิดมาก)
7ตัวอย่างโครงสร้างจริง: VGG
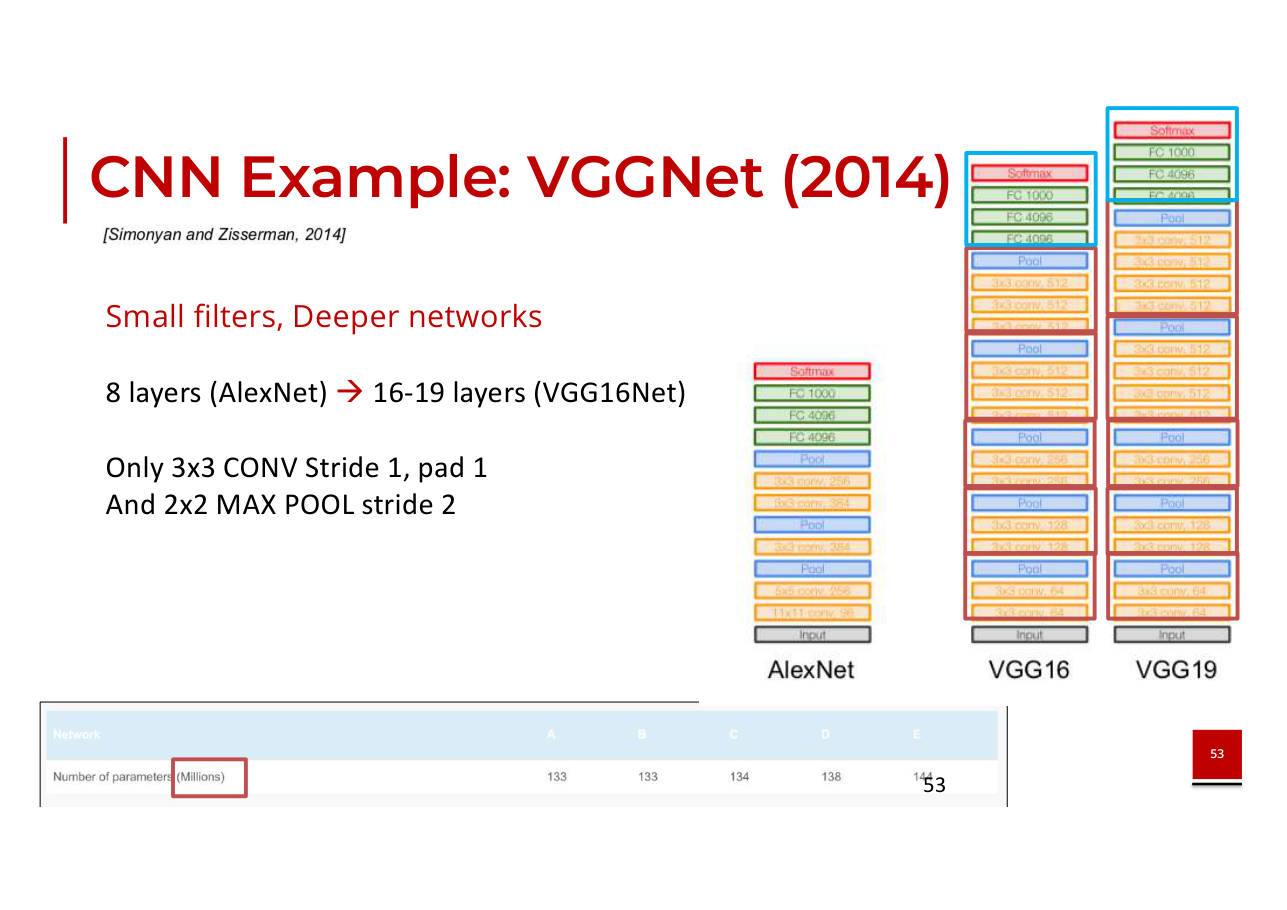
อาจารย์ใบ้ว่า VGG16 ต้องเขียนโค้ดต่อทีละชั้นประมาณสิบกว่าบรรทัด VGG19 ก็สิบกว่าบรรทัด แต่ปัจจุบันไม่มีใครต่อเองแล้ว ใช้ โมเดลที่ต่อไว้เสร็จ (pre-defined/pretrained) แล้วเรียกจากชื่อ (บทถัดไป)
8ลองทำ
- CS231n: Convolutional Networks เป็นแหล่งที่สไลด์อ้างถึง ดูภาพ conv/pool แบบเคลื่อนไหว
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย