Lesson 04 · คาบเช้า 28 ต.ค. · ~20 นาที
Deep Learning คืออะไร และ Embedding vector
1จาก Neural Network สู่ Deep Learning
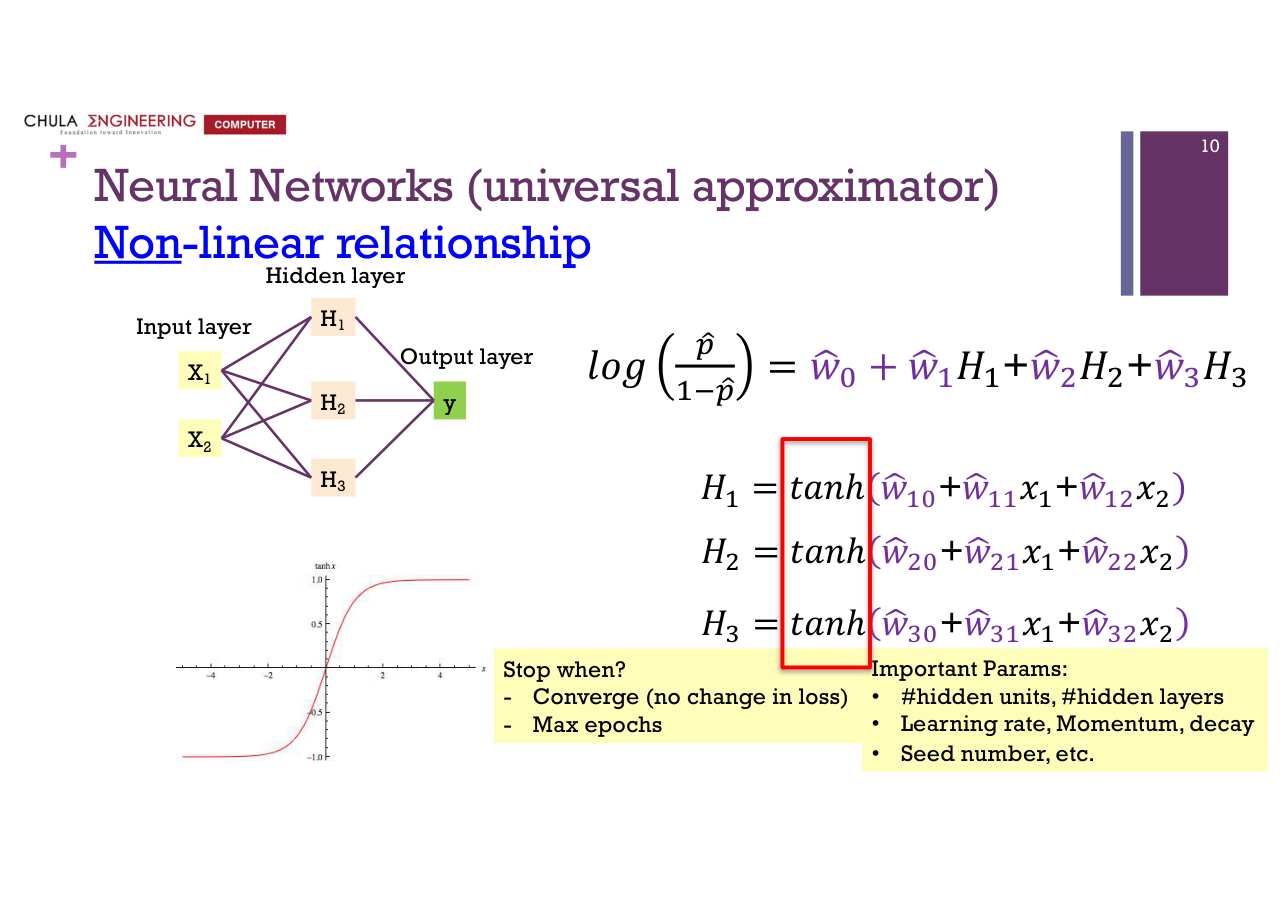
จุดเปลี่ยนสำคัญของวงการคือ back-propagation หลังจากมันเกิดขึ้น เราสามารถนิยามโครงสร้างอะไรก็ได้ แล้วให้เครื่อง (solver) หาค่า weight ให้เอง (ช่วงเช้า ไม่มีไทม์สแตมป์)
สไลด์ 12 กล่าวถึงรางวัลโนเบลของผู้ประดิษฐ์ back-propagation และ Hopfield network (เป็นข้อมูลประกอบ ไม่ใช่ประเด็นสอบ)
2ML ตารางกับ DL ต่างกันที่ข้อมูล
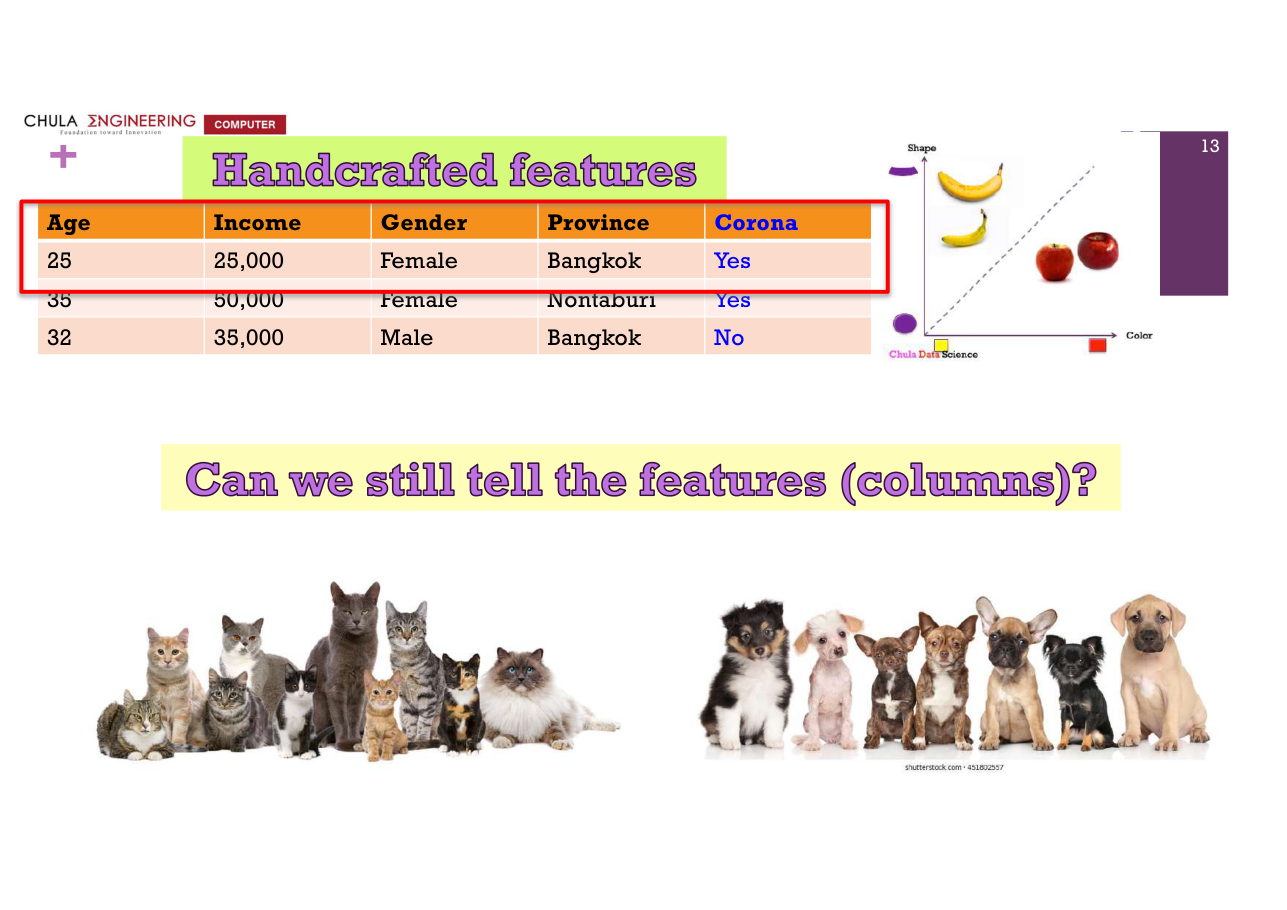
- ML ทั่วไป (scikit-learn): ข้อมูลเป็นตาราง คอลัมน์ทุกตัวคนเป็นคนกำหนด
- DL: ข้อมูลเป็นภาพ เสียง ข้อความ (non-tabular) คนบอกไม่ได้ว่า "คอลัมน์ที่ 3 ควรเป็นอะไร" จึงให้ คอมพิวเตอร์สกัดฟีเจอร์เอง พร้อมกับสร้างโมเดล
ถ้าภาพแอปเปิ้ลกับกล้วย คนยังบอกได้ว่าใช้ สี กับ รูปทรง แต่ถ้าเป็นหมากับแมว จมูกเหลี่ยมหรือกลม? คนบอกไม่ครบ ก็ให้คอมบอก
ถ้าแปลงภาพเป็นตารางแล้ว (สกัดสี รูปทรงมาเป็นคอลัมน์) ก็ใช้ Decision Tree, Regression, kNN ได้เหมือนเดิม ปัญหาอยู่ที่การสกัดฟีเจอร์ ซึ่ง DL ทำให้อัตโนมัติ
โจทย์ของ DL ยังเป็น 3 ประเภทเดิม supervised ถ้าภาพมี label, unsupervised ถ้าไม่มี (เช่น จัดกลุ่มรูปภาพ), และ RL
3Embedding vector
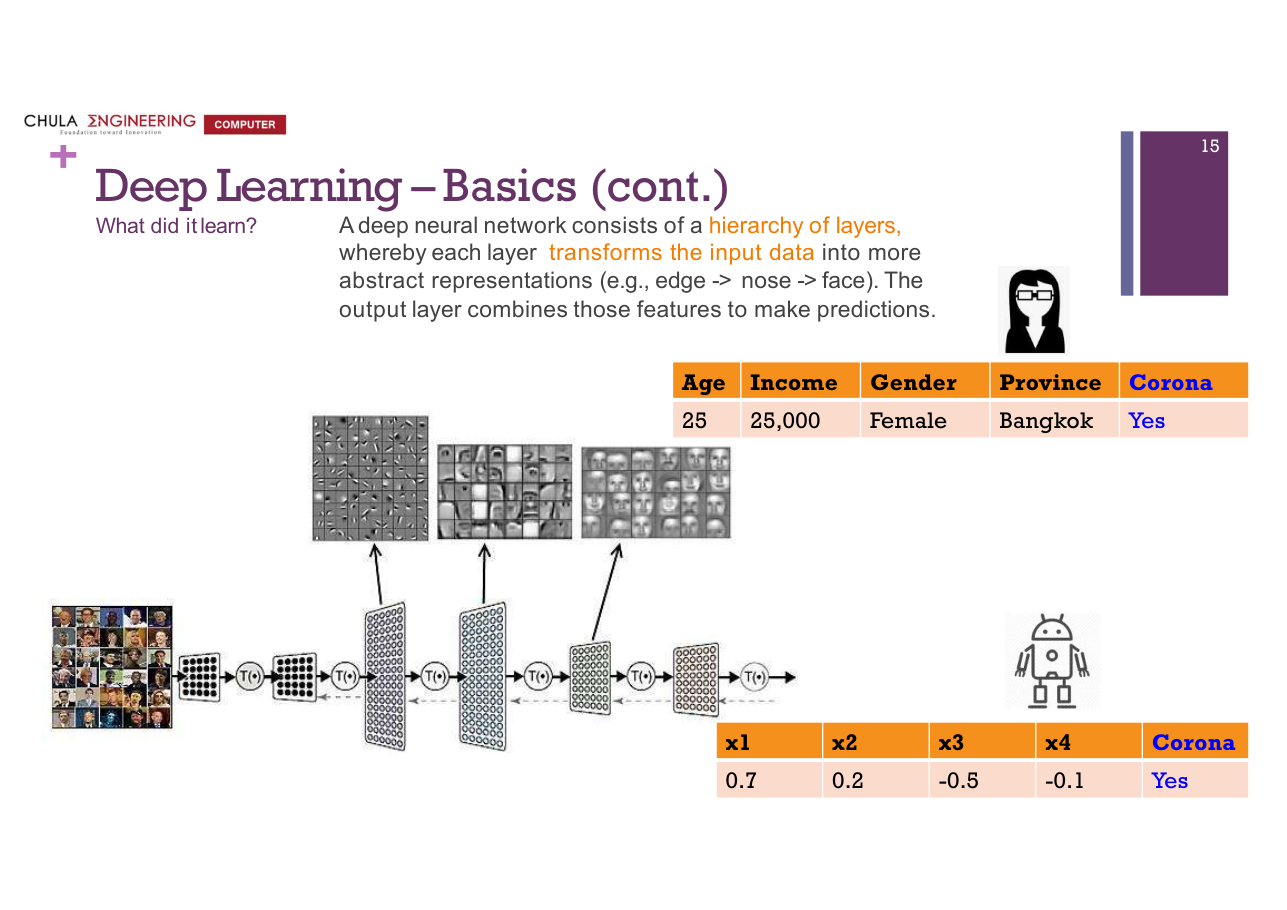
เวกเตอร์ตัวเลขที่ โมเดล DL สกัดมา เป็นตัวแทนของข้อมูลหนึ่งชิ้น (รูปแมวหนึ่งรูป, ข้อความหนึ่งประโยค) เทียบได้กับ "แถวเดียวในตาราง" แต่ต่างตรงที่ ไม่มีใครรู้ว่าแต่ละมิติหมายถึงอะไร รู้แค่ว่ามัน "เหมาะกับโจทย์"
ความหมายของ feature ที่สกัดจะลึกขึ้นตามชั้น: ชั้นต้น ๆ ได้ low-level feature (เส้นขอบ) ชั้นลึกได้ high-level feature (จมูก ใบหน้า)
อาจารย์ย้ำว่า DL ทุกตัวในโลกจะมี embedding vector ออกมาเสมอ (ใช้ซ้ำในบท RAG: ข้อความก็แปลงเป็น embedding เพื่อค้นหา)
ลากจุด "รูปใหม่" ในแผนที่ embedding สมมุติ (2 มิติ) ดูว่ามันอยู่ใกล้กลุ่มไหนแล้วถูกทำนายเป็นอะไร
รูปแมวหนึ่งรูปแปลงเป็น embedding ได้ [0.7, 0.2, −0.5, −0.1] ฟีเจอร์ที่ 1 หมายถึงอะไร
ไม่มีใครรู้ (เหมือน black box) รู้เพียงว่าเวกเตอร์นี้เหมาะกับโจทย์ เช่น แบ่งหมากับแมว
4ทำไม DL เกิดตอนนี้
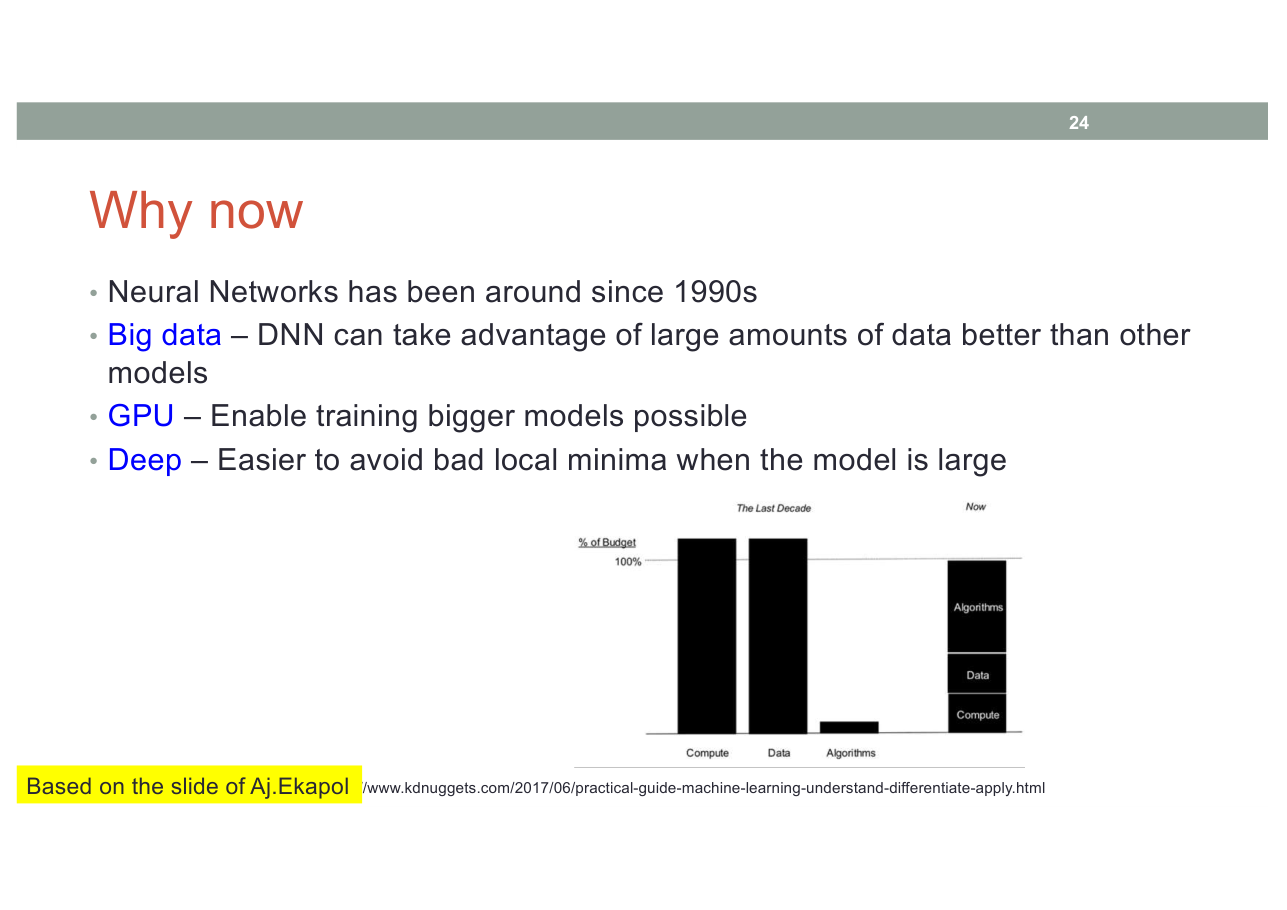
- ข้อมูลไม่ใช่ตารางเพิ่มขึ้น (ยุคมือถือ ภาพ/เสียง/ข้อความเยอะ) และ DL ใช้ข้อมูลเยอะได้ดีกว่าโมเดลอื่น
- GPU: Neural Network คือการคูณเมทริกซ์ GPU เร็วกว่า CPU ราวสิบเท่า ทำให้เทรนโมเดลใหญ่ได้
- โมเดลลึกขึ้น/เทคนิคดีขึ้น (ลึกขึ้นหลีกเลี่ยง local minima ที่ไม่ดีได้ง่ายขึ้น)
สมการ regression มีตัวแปรหลักหน่วย ส่วน Neural Network หนึ่งชั้นมีหลักพันถึงหมื่น DL ซ้อนหลายสิบร้อยชั้นมี weight หลักร้อยล้านตัว (VGG19 ราว 144 ล้านพารามิเตอร์ตามที่อาจารย์เอ่ย) นี่คือเหตุผลว่าทำไมมันเก่ง: โมเดลใหญ่จุความรู้ได้มากแต่เทรนด้วยข้อมูลน้อยไม่ไหว (นำไปสู่บท Pretrained)
5ลองทำ
- 3Blue1Brown: Neural Networks ดูภาพของ weight และ backprop เพิ่มเติม
ติดตรงไหน ถาม Claude ได้เลย บอกเลขบทกับเลขข้อมาด้วย